Cloud-Speicher wird in Unternehmen und im privaten Umfeld häufig über mehrere Geräte parallel genutzt: Notebook im Büro, Smartphone unterwegs, Desktop im Homeoffice. Dabei entscheidet das Synchronisationsmodell, ob Daten lokal vollständig vorliegen, nur teilweise repliziert werden oder erst bei Bedarf geladen werden. Diese Wahl beeinflusst nicht nur den Speicherbedarf und die Netzlast, sondern auch das Verhalten bei Offline-Arbeit, die Fehleranfälligkeit bei gleichzeitigen Änderungen und die Wiederherstellbarkeit nach versehentlicher Löschung. In der Praxis entstehen typische Probleme an Schnittstellen zwischen Dateisystem, Sync-Client und Serverlogik: Dateien erscheinen doppelt, Änderungen überschreiben einander, Ordner bleiben „hängen“ oder ein Gerät zeigt andere Versionen als ein zweites. Wer Cloud-Speicher zuverlässig betreiben oder gezielt Störungen eingrenzen will, benötigt daher ein klares Verständnis der gängigen Synchronisationsmechanismen und ihrer technischen Konsequenzen für Mehrgerätezugriff, Versionierung, Konfliktbehandlung und Sicherheitskontrollen.
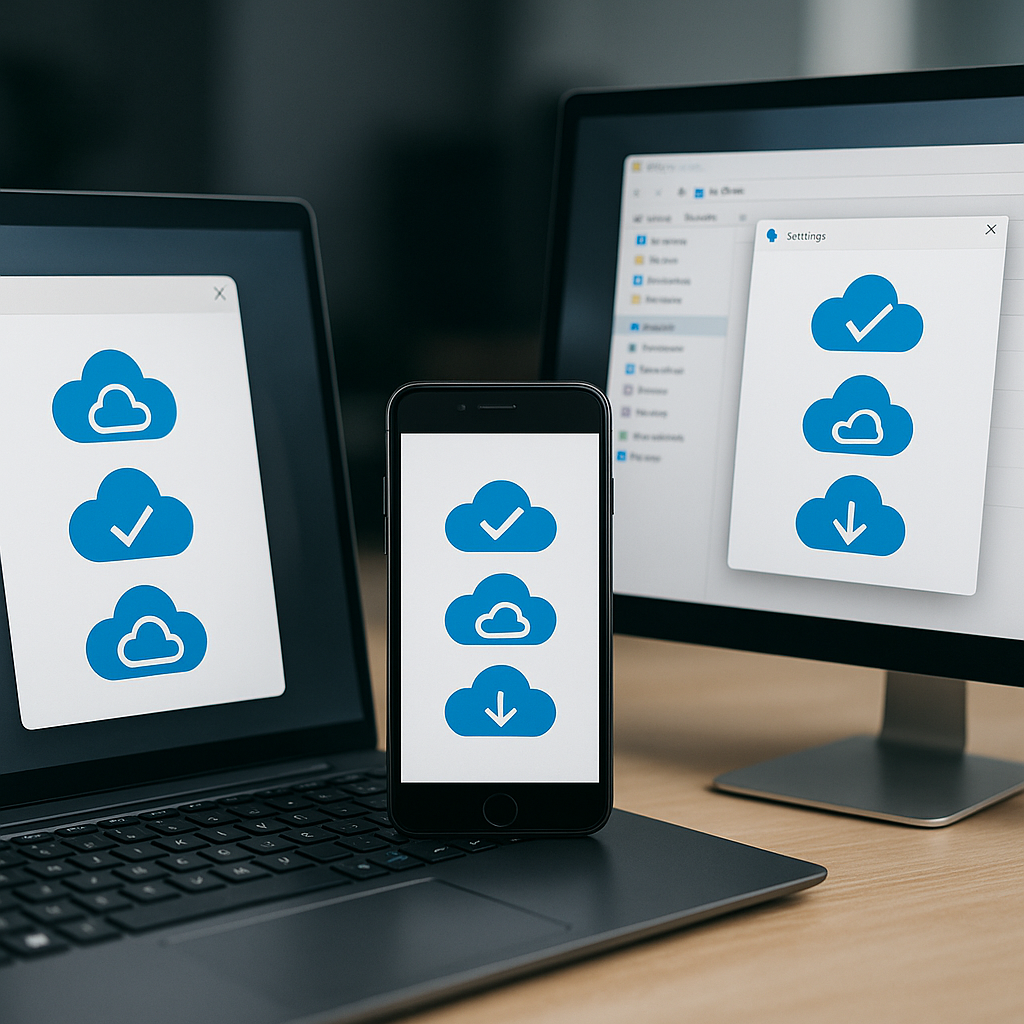
Synchronisationsmodelle in Cloud-Speichern: Definitionen, Abgrenzung und typische Implementierungen
Synchronisation in Cloud-Speichern beschreibt den kontrollierten Abgleich von Dateiinhalten und Metadaten zwischen mindestens einem lokalen Dateisystem und einem entfernten Speicherendpunkt. Technisch relevant sind dabei drei Ebenen: die Datenebene (Inhalte, Prüfsummen, Chunking), die Namens- und Metadatenebene (Pfade, Zeitstempel, ACLs, Labels) sowie die Steuerungsebene (Priorisierung, Bandbreitenmanagement, Konflikterkennung). Cloud-Clients unterscheiden sich weniger durch „ob“ sie synchronisieren, sondern durch die Art, wie lokale Repräsentationen erzeugt werden und wann Inhalte tatsächlich übertragen werden.
Im Alltag werden die Modelle häufig vermischt: „Selektive Synchronisation“ kann als initiale Filterung eines vollständigen Offline-Spiegels implementiert sein, während „On-Demand“ eine Platzhalter-Strategie mit späterer Materialisierung nutzt. Für die saubere Abgrenzung eignen sich zwei Kernfragen: Existiert eine vollständige lokale Kopie der ausgewählten Daten (inklusive Inhalte) oder nur eine logische Repräsentation? Und: Wird die Entscheidung über die lokale Speicherung vom Nutzer, vom System (Policy) oder dynamisch durch Zugriffsmuster getroffen?
Client-Synchronisation (vollständiger Offline-Spiegel): Charakteristika und Grenzen
Beim klassischen Client-Modell lädt der Synchronisationsclient alle in den Sync-Umfang fallenden Dateien vollständig auf das Endgerät und hält sie bidirektional konsistent. Die lokale Datei ist dabei die „Arbeitskopie“; Änderungen werden über Dateisystem-Events (z. B. über Kernel-/API-Mechanismen) erfasst, in einen Upload-Queue überführt und mit serverseitigen Versionen abgeglichen. Dieses Modell ist robust für Offline-Arbeit, erzeugt jedoch planbaren, oft hohen lokalen Speicherbedarf und erfordert eine klare Konfliktstrategie, wenn mehrere Geräte parallel ändern.
Typische Implementierungen arbeiten mit inkrementellen Transfers (Delta/Block-Sync) und resumierbaren Uploads, um große Dateien effizient zu übertragen. Dennoch bleibt der Engpass die lokale Kapazität: Werden große Team-Libraries oder Fotoarchive eingebunden, kann der lokale Cache schnell die verfügbare SSD belegen. Ebenso steigt die Wiederherstellungszeit nach Neuinstallation, weil Inhalte erneut materialisiert werden müssen.
Selektive Synchronisation: statische Umfangssteuerung auf Ordner- und Bibliotheksebene
Selektive Synchronisation reduziert den lokalen Fußabdruck, indem nur explizit ausgewählte Ordner, Bibliotheken oder Pfade in den Offline-Spiegel aufgenommen werden. Nicht ausgewählte Bereiche erscheinen lokal entweder gar nicht oder nur als separate, nicht gemountete Struktur. Der entscheidende Punkt: Für den ausgewählten Teilbereich gilt weiterhin das klassische Client-Modell mit vollständiger Offline-Kopie, einschließlich lokaler Indizierung und Volltextsuche (abhängig vom Betriebssystem).
In Unternehmensumgebungen wird die Auswahl häufig durch Policies vorgegeben (z. B. „nur Projektordner A und B“), um Datenabfluss und Speicherverbrauch zu begrenzen. Selektive Synchronisation ist keine Konfliktlösung, sondern eine Umfangsentscheidung. Konflikte entstehen weiterhin, wenn zwei Endgeräte denselben synchronisierten Pfad bearbeiten. Ein zusätzlicher Randfall: Wird ein Ordner nachträglich abgewählt, verbleiben lokal häufig Artefakte wie Thumbnails, Offline-Indizes oder Anwendungs-Caches außerhalb des Sync-Verzeichnisses, die nicht durch den Cloud-Client bereinigt werden.
On-Demand / Platzhalter-Modelle: lokale Projektion statt lokaler Kopie
On-Demand-Modelle stellen Dateien lokal als Platzhalter dar, die Metadaten (Name, Größe, Zeitstempel, Berechtigungsinformationen) enthalten, jedoch nicht zwingend den Dateiinhalt. Erst bei Zugriff wird der Inhalt heruntergeladen („Hydration“), häufig blockweise, um schnelle Öffnung zu ermöglichen. Umgekehrt kann das System Inhalte wieder entfernen („Dehydration“), wenn Speicher knapp wird oder wenn Policies dies erzwingen. Das lokale Dateisystem bleibt aus Anwendungssicht konsistent, obwohl physisch nicht alle Inhalte vorhanden sind.
Technisch nutzen Betriebssysteme dafür Dateisystem-Erweiterungen oder Filtertreiber, die Öffnungs- und Leseoperationen abfangen und bei Bedarf Netzwerkzugriffe auslösen. Daraus folgen Besonderheiten: Manche Anwendungen erwarten echte Random-Access-Leseleistung oder arbeiten mit temporären Kopien; bei nicht vollständig hydratisierten Dateien kann es zu Wartezeiten, Timeouts oder Teildownloads kommen. Für zuverlässige Offline-Arbeit müssen Dateien explizit als „immer offline verfügbar“ markiert werden; ansonsten ist Offline-Verfügbarkeit ein Nebenprodukt eines früheren Zugriffs, keine Garantie.
| Modell | Lokale Repräsentation | Trigger für Download/Upload | Typische Implementierung |
|---|---|---|---|
| Client (voll) | Vollständige Dateien im Sync-Ordner | Download: initial/bei Änderungen Upload: bei Dateisystem-Events |
Lokaler Index + Queue, optional Delta-Sync |
| Selektiv | Vollständige Dateien, aber nur für ausgewählte Pfade | Wie Client, jedoch nur im selektierten Umfang | Scope-Filter (Ordner/Bibliothek), optional Policy-gesteuert |
| On-Demand | Platzhalter mit Metadaten; Inhalte nur bei Bedarf | Download: Öffnen/Lesen/Prefetch Upload: lokal erzeugte Inhalte + Commit |
File-Provider/Filtermechanismus, Hydration/Dehydration |
Abgrenzung nach Speicher, Offline-Logik und Konfliktflächen
Die praktische Abgrenzung gelingt, wenn Speicherbedarf und Offline-Logik getrennt betrachtet werden. Client- und selektive Modelle erzeugen deterministischen Speicherverbrauch: alles im Umfang liegt als Inhalt vor. On-Demand entkoppelt Sichtbarkeit von Materialisierung; der lokale Speicherbedarf wird damit dynamisch, aber auch schwerer vorherzusagen, weil Cache-Regeln, „zuletzt verwendet“-Heuristiken und administrative Vorgaben zusammenwirken.
Konflikte entstehen überall dort, wo parallele Schreibzugriffe auftreten oder wo ein Gerät mit veralteten Metadaten arbeitet. On-Demand reduziert Konflikte nicht automatisch; es verschiebt sie teilweise, weil Dateiöffnungen hydratisieren und damit späte Downloads in einen bereits geänderten Kontext fallen können. Zusätzlich treten Platzhalter-spezifische Fehlerbilder auf, etwa wenn eine Datei lokal als verfügbar markiert wirkt, der Inhalt aber wegen Authentifizierungsproblemen, Offline-Zustand oder Richtlinien nicht geladen werden kann.
- Deterministische Offline-Verfügbarkeit: Client/selektiv liefern Offline-Verfügbarkeit für den synchronisierten Umfang; On-Demand nur für explizit gepinnte Dateien oder bereits vollständig hydratisierte Inhalte.
- Speichersteuerung: Selektiv begrenzt den Umfang dauerhaft; On-Demand begrenzt primär die Materialisierung und arbeitet mit Cache-Politiken, die sich durch Geräte- und Systemzustand ändern können.
- Konfliktflächen: Alle Modelle benötigen Versions- und Locking-Mechanismen; On-Demand bringt zusätzlich Zustandsübergänge (hydratisiert/dehydratisiert) als Quelle für Timing-Probleme.
- Implementierungsabhängige Metadaten-Abbildung: Unterschiede bei Zeitstempeln, Dateiattributen und Berechtigungen wirken sich auf Build-Systeme, Backup-Tools und DLP-Scanner aus; besonders sensibel sind Fälle, in denen ein Client Cloud-Metadaten nicht 1:1 auf POSIX-/NTFS-Attribute abbilden kann.
Typische Implementierungen: von Sync-Ordnern bis zu File-Provider-Architekturen
Die Mehrzahl der Clients arbeitet weiterhin mit einem oder mehreren Sync-Ordnern im lokalen Dateisystem, ergänzt um eine lokale Datenbank für Status, Prüfsummen und Konfliktzustände. Moderne On-Demand-Varianten integrieren sich tiefer in das Betriebssystem und stellen die Cloud-Struktur als „virtuellen“ Dateibaum mit Platzhaltern dar. Gemeinsam ist beiden Ansätzen ein mehrstufiger Abgleich: (1) Erkennen lokaler Änderungen, (2) Normalisierung in eine interne Repräsentation, (3) Abgleich mit serverseitigem State (meist per ETag/Revision), (4) Commit oder Konfliktpfad.
Unabhängig vom Modell sind typische Grenzen konsistent: Dateisperren sind häufig advisory statt zwingend, sodass parallele Bearbeitung in Office-Formaten anders behandelt wird als in binären Projektdateien. Außerdem bleibt die korrekte Behandlung von Umbenennungen und Verschiebungen anspruchsvoll, weil sie semantisch als Metadatenoperation gelten, in vielen Backends jedoch wie „Delete + Upload“ abgebildet werden können, wenn keine Move-Operation mit stabiler Objekt-ID existiert. Diese Unterschiede prägen die Fehlerbilder bei Mehrgerätezugriff und entscheiden darüber, ob ein Modell eher vorhersehbar oder überraschungsanfällig wirkt.
Tabellarischer Vergleich: Funktionsweise, Speicherbedarf, Offline-Verfügbarkeit, Konfliktbehandlung und Sicherheitsaspekte
Synchronisationsmodelle unterscheiden sich weniger durch die Cloud als durch die lokale Abbildung: Wird ein vollständiger Dateibaum repliziert, werden nur ausgewählte Teilbäume vorgehalten oder existieren lokal primär Platzhalter, die bei Zugriff nachladen? Diese Designentscheidung beeinflusst Speicherdruck auf Endgeräten, Offline-Nutzbarkeit, Konfliktrisiken bei parallelem Arbeiten sowie die praktische Angriffsfläche bei Verlust oder Kompromittierung eines Clients. Der folgende Vergleich fokussiert deshalb konsequent auf Funktionsweise, Ressourcenbedarf, Konfliktbehandlung und Sicherheitsimplikationen.
Vergleichstabelle: Synchronisationstypen im Detail
| Synchronisationstyp | Funktionsweise (lokale Abbildung) | Speicherbedarf (Client) | Offline-Verfügbarkeit | Konfliktbehandlung (typisch) | Sicherheitsaspekte (Schwerpunkte) |
|---|---|---|---|---|---|
| Vollständige Client-Synchronisation | Alle ausgewählten Bibliotheken/Ordner werden vollständig lokal repliziert. Änderungen werden per Delta/Block- oder Dateiebene übertragen (anbieterabhängig) und anschließend serverseitig versioniert. | Hoch: entspricht (nahezu) der Datenmenge plus Metadaten/Cache. Zusätzlicher Bedarf durch lokale Versions-/Datenbankdateien des Sync-Clients möglich. | Sehr hoch: vollständiger Datenbestand steht ohne Netzverbindung bereit; Einschränkungen primär bei serverseitigen Freigaben/ACL-Änderungen. | Meist „Last writer wins“ mit Konfliktkopien (z. B. zweite Datei mit Gerätename/Datum). Teilweise Sperrmechanismen für Office-/Collaboration-Dateien, je nach Ökosystem. | Maximale Exponierung bei Geräteverlust, da Inhalte vollständig auf dem Datenträger liegen. Erfordert konsequente Laufwerksverschlüsselung, Geräteschutz und saubere Berechtigungshygiene. Malware-Risiko höher, da viele Dateien lokal aktiv sind. |
| Selektive Synchronisation | Nur explizit ausgewählte Ordner/Projekte werden lokal repliziert; der restliche Cloud-Bestand bleibt ausschließlich remote sichtbar oder wird im Client ausgeblendet. | Mittel: abhängig von Auswahl. Metadaten zur Auswahlverwaltung und Indexierung fallen dennoch an, aber deutlich geringer als bei Vollsync. | Hoch für ausgewählte Inhalte; nicht synchronisierte Bereiche sind offline nicht verfügbar bzw. nur als nicht zugreifbare Verweise. | Konflikte konzentrieren sich auf aktiv synchronisierte Teilbereiche. Konfliktdateien entstehen häufiger, wenn Teams unterschiedliche Selektionssätze haben und parallel dieselben Pfade bearbeiten. | Reduziert Datenabflussfläche auf dem Client, verbessert Compliance bei BYOD/geringen Speicherkontingenten. Risiko bleibt für synchronisierte Inhalte identisch; falsche Auswahl kann ungewollt sensible Daten lokal ablegen. |
| On-Demand / Smart Sync / Files On-Demand | Dateien erscheinen im Dateisystem als Platzhalter (Metadaten, ggf. Thumbnail). Inhalt wird bei Zugriff gestreamt/heruntergeladen; „Anheften“ markiert Dateien/Ordner für dauerhafte lokale Verfügbarkeit. | Niedrig bis variabel: Basisbedarf vor allem für Metadaten, lokalen Index und Cache. Bedarf steigt mit angehefteten Dateien sowie mit temporären Download-/Anwendungs-Caches. | Gemischt: nur angeheftete Inhalte zuverlässig offline. Platzhalter bleiben sichtbar, aber Öffnen ohne Netz führt zu Fehlern; Anwendungen können dabei unterschiedliche Fehlermodi zeigen. | Konfliktbehandlung wie bei anderen Modellen, jedoch mit zusätzlicher Fehlerklasse: Bearbeitung beginnt offline an nicht angeheftetem Platzhalter oder in Apps, die beim Speichern atomare Umbenennungen durchführen. Das kann zu Doppeldateien oder Upload-Fehlschlägen führen. | Weniger ruhende Daten auf dem Gerät, daher geringere Folgen bei Verlust. Gleichzeitig entstehen neue Angriffs-/Leakage-Pfade: temporäre Klartextkopien im Cache, Vorschau-/Index-Inhalte sowie lokale Suchindizes. Richtlinien für Cache-Löschung, Verschlüsselung und „Offline immer anheften“ für kritische Daten sind relevant. |
Interpretation der Spalten: praktische Konsequenzen im Betrieb
Beim Speicherbedarf entscheidet nicht nur die Nutzdatenmenge. Viele Sync-Clients halten lokale Datenbanken für Zustands- und Konflikterkennung, Hashes, Journale sowie Download-/Upload-Warteschlangen. On-Demand-Modelle wirken zunächst sparsam, können aber durch Caching, Vorschaudateien und das „Anheften“ ganzer Teams-Ordner schleichend wieder in den Bereich einer Vollsync rutschen. Selektive Synchronisation bleibt am berechenbarsten, solange Auswahlregeln organisatorisch stabil bleiben.
Offline-Verfügbarkeit ist technisch klar, operativ jedoch von Applikationsverhalten abhängig. Programme, die beim Speichern zunächst temporäre Dateien anlegen und anschließend umbenennen, provozieren bei instabiler Verbindung häufiger Inkonsistenzen als Anwendungen mit sauberem Datei-Locking. Bei On-Demand sind zudem „Pseudo-Offline“-Zustände typisch: ein Pfad ist sichtbar, aber nicht lesbar; automatisierte Prozesse (Backups, Build-Skripte, Media-Indexer) können dadurch fehlschlagen oder unerwartet große Datenmengen nachladen.
Konfliktbehandlung: typische Muster und Grenzen
Konflikte entstehen, wenn zwei Änderungsströme zeitlich überlappen und sich nicht deterministisch zusammenführen lassen. Viele Systeme behandeln Binärformate als unteilbar und erzeugen deshalb Konfliktkopien. Bei textbasierten Formaten ist eine automatische Zusammenführung möglich, wird aber von klassischen Dateisync-Clients selten auf Inhaltsebene umgesetzt, da dafür Formatkenntnis und ein Merge-Algorithmus erforderlich wären. Sperrmechanismen („Co-Authoring“ in integrierten Office-Ökosystemen) reduzieren Konflikte, verschieben das Problem aber in Richtung Berechtigungs- und Lock-Timeout-Fehler.
- Konfliktkopie statt Merge: Zwei Versionen werden als getrennte Dateien abgelegt, häufig mit Suffix (Gerätename/Benutzer/Zeit). Dadurch bleibt Inhalt erhalten, aber es entsteht manueller Abgleichaufwand; zudem riskieren nachgelagerte Workflows (z. B. Import-Jobs) die Verarbeitung der falschen Datei.
- „Last writer wins“ mit Versionierung: Der zuletzt erfolgreich hochgeladene Stand wird als aktuell markiert, frühere Stände bleiben als Versionen abrufbar. Das verhindert Datenverlust nur, wenn Versionierung aktiviert ist und Aufbewahrungsfristen lang genug sind, um spätes Bemerken abzudecken.
- Locking/Check-out: Schreibzugriffe werden exklusiv vergeben, andere Clients erhalten nur Lesezugriff oder müssen warten. Locks reduzieren Konflikte, erhöhen aber die Störanfälligkeit bei abgebrochenen Sessions und erzeugen Supportfälle rund um „Datei gesperrt“.
Sicherheitsaspekte: Bedrohungsmodell abhängig vom Synchronisationsmodus
Die zentrale Unterscheidung lautet: Daten „at rest“ auf dem Endgerät versus Daten primär in der Cloud. Vollsync maximiert die lokale Angriffsfläche (Diebstahl, forensische Extraktion, lokale Malware, Schattenkopien/Backups). Selektive Synchronisation reduziert diese Fläche, verlangt aber Governance, damit Teams nicht aus Bequemlichkeit ganze Strukturen lokal spiegeln. On-Demand reduziert ruhende Daten, schafft jedoch Abhängigkeiten von Cache- und Index-Verhalten: Inhalte können kurzzeitig im Klartext im Download-Cache liegen, Suchindizes können Dateiinhalte oder Metadaten persistieren, und Offline-Dateien sind oft schwerer zu inventarisieren, wenn „Anheften“ dezentral erfolgt.
Für alle Modelle bleibt identisch: Transportverschlüsselung ist Standard, entscheidend sind lokale Schutzmaßnahmen (Vollverschlüsselung, sichere Anmeldeverfahren, Endpoint-Protection), saubere Rechtevergabe und die konsequente Nutzung von Versionierung/Retention gegen versehentliche Löschung oder Ransomware-Szenarien. Der Synchronisationsmodus bestimmt dabei, wie schnell sich Schad- oder Fehländerungen ausbreiten: Vollsync repliziert flächig, selektiv und On-Demand begrenzen die Reichweite oft auf aktive Arbeitsbereiche, können aber durch automatisches Nachladen (Indexing, Antivirus-Scan, Backup) unerwartet wieder großflächig werden.
Fehlerbilder und Diagnosepraxis: Mehrgerätezugriff, Versionskonflikte, Sync-Stau und versehentliche Dateilöschung
Synchronisationsprobleme wirken häufig wie „Netzwerkfehler“, entstehen in der Praxis aber ebenso durch parallele Bearbeitung auf mehreren Geräten, uneindeutige Konfliktauflösung, inkonsistente Offline-Caches oder durch Lösch- und Wiederherstellungslogik (Papierkorb/Versionierung/Retention). Die Diagnose profitiert von einem klaren Raster: Was ist lokal vorhanden, was liegt serverseitig vor, welche Ereignisse wurden vom Client protokolliert und welche Reihenfolge von Änderungen lässt sich rekonstruieren.
Mehrgerätezugriff: typische Inkonsistenzen und ihre Ursachen
Bei Mehrgerätezugriff steigt die Wahrscheinlichkeit, dass zwei Clients denselben Pfad in kurzer Zeit verändern. In Client-Sync-Modellen (vollständige Spiegelung) treten Konflikte oft erst beim nächsten Abgleich auf, während On-Demand-Modelle zusätzliche Zustände besitzen: Platzhalterdateien, teilweise heruntergeladene Inhalte und serverseitig priorisierte Metadaten. Selektive Synchronisation verschärft Sonderfälle, weil einzelne Ordner auf manchen Geräten nie lokal existieren und damit lokale Prüfungen (z. B. „Datei ist vorhanden“) irreführend werden können.
Häufige Fehlerbilder sind „verschwindende“ Dateien (tatsächlich nur unsynchronisierte Ordner), doppelte Dateien mit Konfliktsuffix, oder Dateien, die auf Gerät A aktuell wirken, auf Gerät B aber eine ältere Version zeigen. Hinter solchen Symptomen stehen oft Reihenfolgeeffekte: Gerät B arbeitet offline, Gerät A ändert und synchronisiert, danach kommt Gerät B online und lädt seinen älteren Stand hoch. Ohne robuste Konfliktlogik werden Änderungen überschrieben oder in Konfliktkopien abgelegt.
- Reproduzierbarkeit sichern: Zeitstempel notieren (lokal und serverseitig) und die Abfolge „Bearbeiten → Speichern → Sync abgeschlossen“ je Gerät dokumentieren; bei Bedarf Synchronisation kurz pausieren, um Reihenfolgen nicht weiter zu vermischen (z. B.
onedrive.exe /shutdownunter Windows oder „Sync pausieren“ in der Client-Oberfläche). - Pfad- und Kontenprüfung: Abgleichen, ob alle Geräte denselben Account und denselben Root verwenden und ob selektive Regeln identisch sind (z. B. Ordner auf Gerät B nicht ausgewählt). Unter macOS kann eine zweite Anmeldung in derselben App zu „Parallelbibliotheken“ führen, die optisch ähnlich wirken.
- Dateisperren und Co-Authoring: Bei Office- und kollaborationsfähigen Formaten reduziert serverseitiges Co-Authoring Konflikte, bei binären Formaten (z. B.
.pst, viele.sqlite,.zip) erhöhen parallele Schreibzugriffe die Gefahr korrupt wirkender Uploads oder dauerhafter Wiederholversuche. - On-Demand-Fallen: Platzhalter („nur online“) können lokal wie vorhanden erscheinen, sind aber ohne Download nicht prüfbar; eine Anwendung kann beim Öffnen im Offline-Zustand eine leere/teilweise Datei erzeugen, die später als Änderung hochgeladen wird. Hinweise liefern Statusfelder wie „Nur online“, „Lokal verfügbar“ oder „Immer auf diesem Gerät behalten“.
Versionskonflikte: Erkennen, Einordnen, Auflösen
Konflikte entstehen, wenn zwei unterschiedliche Inhaltsstände denselben Objektbezeichner (Pfad/ID) beanspruchen und der Dienst keine eindeutige Merge-Operation durchführen kann. Viele Clients lösen das über „Konfliktkopien“ (zweite Datei mit Suffix) oder über serverseitige Versionierung mit einem „zuletzt schreibenden“ Gewinner. Entscheidend ist die Unterscheidung zwischen echten Inhaltskonflikten und reinem Metadatenkonflikt (z. B. Umbenennung vs. Inhalt).
| Konfliktsymptom | Wahrscheinliche Ursache | Diagnosehinweis | Saubere Auflösung |
|---|---|---|---|
| „Konfliktkopie“ mit Namenszusatz | Gleichzeitige Bearbeitung auf zwei Clients | Protokoll zeigt Upload beider Varianten; Zeitstempel nahe beieinander | Inhalte vergleichen, zusammenführen, danach eine Version behalten und die andere gezielt löschen |
| Änderungen „verschwinden“ nach kurzer Zeit | Spätes Hochladen eines Offline-Clients überschreibt | Gerät war offline; nach Onlinegang viele Uploads in kurzer Zeit | Versionshistorie/Serverversion prüfen, betroffene Datei aus Version wiederherstellen, Offline-Client stoppen und bereinigen |
| Datei lässt sich nicht öffnen / wirkt beschädigt | Teil-Upload, Abbruch, oder ungeeigneter Dateityp für Sync | Wiederholte Upload-Versuche im Client; Datei wächst/ändert sich während Upload | App schließen, Datei lokal konsistent erzeugen (Export/Backup), dann erneut hochladen; problematische Dateien aus Sync ausschließen |
| Umbenennung wird „zurückgedreht“ | Race zwischen Rename und Upload einer älteren Ordnerliste | Mehrere Geräte ändern Struktur; besonders bei großen Ordnern | Sync auf allen Geräten abwarten, dann Umbenennung einmal zentral durchführen; danach keine parallelen Strukturänderungen |
Sync-Stau und „Endlossynchronisation“: Ursachenketten und Messpunkte
Sync-Stau zeigt sich als dauerhaftes „Synchronisiere…“, steigender Rückstand („x Dateien ausstehend“) oder als wiederkehrende Fehlermeldungen zu denselben Objekten. Technisch dominieren vier Ursachenklassen: Authentifizierung (abgelaufene Tokens, MFA-Änderungen), Dateisystemgrenzen (Pfadlängen, ungültige Zeichen, case-sensitivity), Inhaltsprobleme (Datei wird permanent geändert/gesperrt) und Infrastruktur (Proxy/TLS-Inspection, blockierte Endpunkte, instabile Verbindung). On-Demand fügt Download-Staus hinzu, etwa bei sehr vielen Platzhaltern oder wenn lokale Cache-Grenzen erreicht werden.
- Clientstatus und Queue prüfen: In vielen Clients existiert eine Ansicht für „Probleme“/„Aktionen erforderlich“. Wiederholt auftauchende Objekte isolieren, indem der betroffene Pfad temporär verschoben wird (außerhalb des Sync-Roots), um zu sehen, ob der Stau abklingt.
- Typische Namens- und Pfadfehler: Ungültige Zeichen und reservierte Namen bremsen Dienste je nach Plattform; auch sehr tiefe Verzeichnisstrukturen können scheitern. Symptome sind „Kann nicht synchronisiert werden“ bei stets denselben Pfaden und ein sofortiges Wiederauftreten nach jedem Retry.
- Locking durch Anwendungen: Datenbanken, virtuelle Festplatten oder Mailarchive bleiben offen und ändern sich kontinuierlich; der Client versucht inkrementell hochzuladen und startet wieder neu. Diagnose über Prozessbezug (Datei in Benutzung) und testweises Beenden der App, die den Schreibzugriff hält.
- Netzwerk-/Proxy-Fehlerbild: TLS-Inspection oder restriktive Proxies führen zu sporadischen Uploadabbrüchen, während Downloads noch funktionieren. Indikatoren sind wechselnde Fehlcodes, nur in bestimmten Netzsegmenten. Abhilfe erfordert in der Regel Freigaben für die Cloud-Endpunkte und stabile MTU/Timeout-Settings, nicht „Neuinstallation“ des Clients.
Versehentliche Dateilöschung: Wiederherstellung, Re-Sync und Nebenwirkungen
Löschungen propagieren in Synchronisationssystemen als normale Änderung und werden deshalb zuverlässig verteilt. Kritisch wird es, wenn ein Gerät einen veralteten lokalen Zustand als „Quelle der Wahrheit“ behandelt oder wenn selektive Synchronisation den Eindruck erzeugt, ein Ordner sei gelöscht, obwohl er nur abgewählt wurde. Auch Bereinigungstools, Storage-Sense-Mechanismen oder Drittanbieter-AV können Dateien verschieben/quarantänieren, was der Sync-Client als Löschung interpretiert.
Die Diagnose beginnt mit der Unterscheidung zwischen „lokal gelöscht“, „serverseitig gelöscht“ und „nur nicht mehr lokal verfügbar“ (On-Demand). Danach folgt die Prüfung, ob eine Wiederherstellung über Papierkorb/Recycle Bin und Versionshistorie möglich ist und ob eine Retention- oder eDiscovery-Policy das Verhalten verändert. Bei Massendeletionen ist Geschwindigkeit entscheidend: Je länger Clients weiter synchronisieren, desto mehr Geräte übernehmen die Löschung, und desto schwieriger wird die Rekonstruktion ohne sekundäre Backups.
- Sofortmaßnahme bei Massendeletion: Synchronisation auf allen Geräten pausieren und problematische Clients offline nehmen, um weitere Löschpropagation zu stoppen; bei Windows-Clients kann ein kontrolliertes Beenden mit
onedrive.exe /shutdownhelfen, bevor wieder verbunden wird. - Papierkorb vs. Versionen: Papierkorb stellt gelöschte Objekte wieder her, Versionshistorie stellt frühere Inhaltsstände derselben Datei wieder her. Bei Konflikten nach Wiederherstellung kann es sinnvoll sein, die Datei unter neuem Namen wiederherzustellen und anschließend gezielt zu konsolidieren.
- Selektive Synchronisation richtig interpretieren: Ein abgewählter Ordner ist nicht gelöscht; lokal verschwindet er, serverseitig bleibt er bestehen. Diagnose durch Vergleich in der Weboberfläche und durch Prüfen der Sync-Auswahl, bevor Wiederherstellungen angestoßen werden.
- Re-Sync sauber anstoßen: Nach Wiederherstellungen sollten betroffene Clients erst dann wieder synchronisieren, wenn der serverseitige Bestand konsistent ist. In hartnäckigen Fällen ist ein Neuaufbau des lokalen Sync-Caches sinnvoller als wiederholtes „Retry“, erfordert aber kontrolliertes Vorgehen, damit keine alten lokalen Stände erneut hochgeladen werden.
Werbung

(**) UVP: Unverbindliche Preisempfehlung
Preise inkl. MwSt., zzgl. Versandkosten