SMART-Daten (Self-Monitoring, Analysis and Reporting Technology) gehören zu den wenigen kontinuierlich verfügbaren Diagnosequellen direkt aus HDD- und SSD-Laufwerken. In der Praxis führen sie jedoch häufig zu Fehlinterpretationen: Tools zeigen Dutzende Attribute, die Normalisierung variiert je nach Hersteller, und der entscheidende Rohwert ist ohne Kontext schwer einzuordnen. Gleichzeitig hängt an einer korrekten Bewertung oft eine konkrete Entscheidung – etwa ob ein System weiterbetrieben werden kann, ob ein Backup-Risiko besteht oder ob ein Laufwerk vorsorglich ersetzt werden sollte. Besonders problematisch sind stille Degradationen wie wachsende Reallocated-Sektoren bei HDDs oder steigender Wear-Level bei SSDs, die lange unauffällig bleiben, bis Lesefehler, Performanceeinbrüche oder Dateisystemkorruption auftreten. Wer SMART-Werte belastbar interpretieren will, muss verstehen, welche Attribute auf physische Defekte, Medienfehler, Firmware-Remapping, Schnittstellenprobleme oder schlicht normale Alterung hindeuten, wie Schwellenwerte tatsächlich verwendet werden und welche Muster als Frühwarnsignal für drohenden Datenverlust gelten.
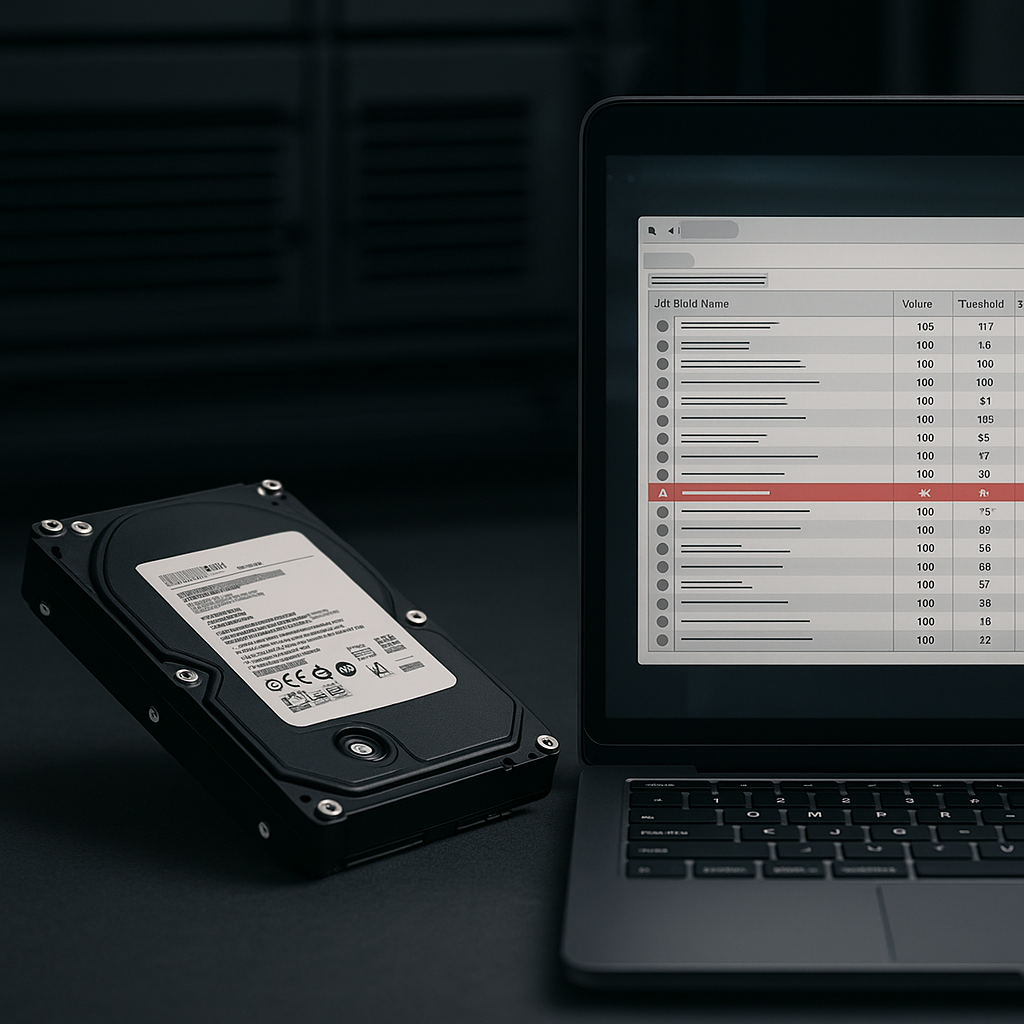
SMART-Grundlagen: Normalized Value, Worst, Threshold und Rohwert richtig verstehen
SMART-Attribute bestehen in der Praxis fast immer aus zwei Ebenen: einer vom Hersteller normalisierten Bewertungszahl (meist als „Value“, „Current“ oder „Normalized Value“ angezeigt) und einem Rohwert („Raw Value“), der das zugrunde liegende Zähler- oder Messsignal abbildet. Diagnosen scheitern häufig daran, dass diese Ebenen verwechselt oder herstellerübergreifend gleichgesetzt werden. Besonders bei SSDs kommt hinzu, dass ein einzelnes Attribut verschiedene, teils zusammengesetzte Rohwertfelder enthalten kann.
SMART ist keine einheitliche Norm mit verbindlicher Semantik pro Attribut-ID. Zwar existieren verbreitete Zuordnungen (etwa Reallocated Sectors bei ID 5), aber sowohl die Skalierung des normalisierten Werts als auch die Kodierung des Rohwerts werden vom Hersteller festgelegt. Aussagekräftig ist daher primär die Kombination aus Trend, Plausibilität und Kontext: Laufwerkstyp (HDD/SSD), Workload, Temperaturführung, Betriebszeit und vorhandene Fehlerkorrekturmechanismen.
Normalized Value („Current“): Bewertungsskala statt Messwert
Der normalisierte Wert ist eine Zustandskennzahl, typischerweise auf einer Skala von 1 bis 253. Viele Hersteller starten bei 100 oder 200 und lassen den Wert bei Verschleiß oder Fehlerereignissen sinken. Der entscheidende Punkt: Dieser Wert ist kein direkt physikalischer Messwert, sondern eine verdichtete, herstellerinterne Bewertung. Zwei Laufwerke können bei identischem Rohwert sehr unterschiedliche Normalized Values ausweisen, weil die Bewertungskurve (Mapping) anders definiert ist.
Ein hoher Normalized Value bedeutet nicht automatisch „gesund“, sondern lediglich „oberhalb der vom Hersteller definierten Alarmgrenze“. Umgekehrt ist ein sinkender Wert ohne gleichzeitige Rohwertänderung ein Warnsignal, dass der Hersteller zusätzliche interne Kriterien einbezieht (z. B. Fehlerhäufigkeit pro Zeit, Korrekturaufwand oder Schwellwertlogik mit Hysterese).
Worst („Schlechtester Wert“): Historie mit Diagnosewert
„Worst“ protokolliert den niedrigsten jemals beobachteten Normalized Value seit Inbetriebnahme oder seit dem letzten Zurücksetzen der SMART-Daten (je nach Tool und Firmware). Bei HDDs kann Worst durch temporäre Bedingungen beeinflusst werden, etwa durch thermische Spitzen oder Phasen erhöhter Lesekorrekturen. Bei SSDs ist Worst oft eng an Wear-Indikatoren gekoppelt und ändert sich daher eher monoton, aber nicht zwingend strikt linear.
Diagnostisch ist Worst besonders dann relevant, wenn der aktuelle Normalized Value wieder „besser“ aussieht, beispielsweise nach einer Abkühlung oder nach Phasen geringerer I/O-Last. Worst konserviert solche Ereignisse und verhindert, dass kurzfristige Normalisierungen die Historie überdecken. Allerdings ersetzt Worst keine Ereignisanalyse: Ein einmaliger Ausreißer ist anders zu bewerten als ein schrittweiser Abfall über Wochen.
Threshold („Grenzwert“): Ausfallkriterium, nicht Qualitätsziel
Der Threshold ist der vom Hersteller gesetzte Grenzwert, bei dessen Unterschreitung das Attribut als fehlgeschlagen gilt („SMART FAIL“ bzw. „Pre-fail“). Dieser Grenzwert ist häufig konservativ im Sinne von „spät“: Viele Laufwerke zeigen klare Frühindikatoren im Rohwert lange bevor der Normalized Value den Threshold erreicht. In der Praxis bedeutet das: Ein nicht ausgelöster SMART-Fail ist kein Freifahrtschein, sondern nur die Aussage, dass die formale Grenzverletzung nicht eingetreten ist.
Einige Attribute sind zudem als „Old age“ klassifiziert und haben Thresholds, die eher als Lebensdauerindikator dienen (z. B. SSD-Verschleiß). Andere sind „Pre-fail“ und sollen drohende mechanische oder mediale Probleme anzeigen (z. B. umverteilte Sektoren bei HDDs). Die Klassifikation ist dennoch kein Ersatz für die Rohwertinterpretation, da Hersteller die Bedeutung uneinheitlich pflegen.
| Feld in SMART-Tools | Was es ist | Typische Fallstricke in der Praxis |
|---|---|---|
| Normalized Value (Current) | Herstellerbewertung auf einer Skala (oft 100/200 startend, fallend bei Problemen) | Zwischen Herstellern nicht vergleichbar; kann ohne sichtbaren Rohwertsprung sinken (interne Heuristiken) |
| Worst | Niedrigster historischer Normalized Value | Kann durch kurzzeitige Extrembedingungen geprägt sein; Rückschlüsse nur mit Kontext (Temperatur, Last, Zeitraum) |
| Threshold | Grenzwert für „Attribut fehlgeschlagen“ | Oft spät ansprechend; fehlender Fail bedeutet nicht „keine Gefahr“, sondern „keine formale Grenzverletzung“ |
| Raw Value | Rohzähler/Messwert (häufig 48 Bit, toolabhängig dargestellt) | Einheit und Kodierung herstellerabhängig; Dezimal/Hex-Darstellung und Bitfelder können Interpretation verfälschen |
Rohwert („Raw Value“): Zähler, Messgröße oder Bitfeld
Der Rohwert ist das wichtigste Diagnoseelement, weil er die „Messseite“ abbildet. Bei HDDs sind Rohwerte oft echte Zähler (z. B. Anzahl umverteilter Sektoren), bei anderen Attributen aber komplexe Kodierungen: Manche Hersteller packen mehrere Teilwerte in ein 48- oder 64-Bit-Feld (z. B. Ereigniszähler plus Fehleranzahl). Bei SSDs ist die Rohwertsemantik besonders heterogen: Schreib-/Lesemengen können in LBAs, GiB, 32-MiB-Einheiten oder Hersteller-“Units“ kodiert sein; Wear-Indikatoren können Prozent, verbleibende Reserve oder „Used“ darstellen.
Tools unterscheiden sich außerdem in der Darstellung. Manche geben Rohwerte als Dezimalzahl aus, andere als Hex; wieder andere dekodieren Teilfelder herstellerspezifisch. Eine Rohwertzahl ohne Kenntnis der Einheit kann daher wertlos sein. Verlässlicher sind relative Veränderungen über die Zeit, korreliert mit Ereignissen wie Stromausfällen, Transport, Firmware-Updates oder geänderten Workloads.
- Darstellungsform prüfen: Rohwerte je nach Tool als Dezimal oder Hex; bei Unsicherheit Rohwertansicht vergleichen, etwa mit
smartctl -a /dev/sdXundsmartctl -x /dev/sdX. - Einheiten nicht vermuten: „Total LBAs Written“ kann 512-Byte-LBA, 4K-Äquivalente oder Hersteller-Units bedeuten; belastbar werden Werte erst mit Herstellerdoku oder plausibilisierter Trendbetrachtung.
- Bitfelder berücksichtigen: Einige Attribute kombinieren Zähler in High-/Low-Parts; eine rein dezimale Interpretation kann Fehlalarme erzeugen, wenn eigentlich nur ein Teilfeld steigt.
- Trend vor Momentaufnahme: Sprünge bei
Reallocated_Sector_Ct(ID 5) oderCurrent_Pending_Sector(ID 197) sind bei HDDs relevanter als stabile, kleine Werte; bei SSDs sind monotone Wear-Zähler erwartbar. - Fehlerlog mitlesen: Rohwerte gewinnen Bedeutung im Zusammenspiel mit SMART-Logs, etwa
smartctl -l error /dev/sdXundsmartctl -l selftest /dev/sdX.
Praktische Lesereihenfolge: Von „Fail“ zu Ursachenindikatoren
Für eine robuste Einordnung bietet sich eine feste Reihenfolge an: Zuerst die formale Fail-Logik (Threshold-Unterschreitung) prüfen, dann die Historie (Worst, Fehlerlogs, Selftests) und erst danach einzelne Rohwerte interpretieren. Der Normalized Value dient dabei als grober, herstellerspezifischer Zustandsindex; der Rohwert liefert die technische Substanz. Bei Widersprüchen gilt: Rohwerte plus Logs sind meist aussagekräftiger als eine alleinige „Good/Bad“-Ampel.
Ein typisches Beispiel ist die HDD-Situation „Pending Sectors steigen, Reallocated bleibt noch 0“: Der Normalized Value kann unverändert bleiben, obwohl reale Lesefehler vorliegen. Umgekehrt kann ein SSD-Wear-Attribut kontinuierlich sinken, ohne dass ein akuter Defekt vorliegt. In beiden Fällen führt erst die korrekte Zuordnung von Normalized Value, Worst, Threshold und Rohwert zu einer sauberen Diagnose, die zwischen Verschleiß, Medienfehlern, Schnittstellenproblemen und Umgebungsfaktoren unterscheiden kann.
SMART-Attribute als Referenz: IDs, Bedeutung, typische Rohwerte, Grenzbereiche und praktische Interpretation (HDD/SSD) – tabellarisch
SMART-Attribute werden je nach Hersteller und Tool als normalisierte Werte (meist 0–100 oder 0–253), als definierter Schwellwert („Threshold“) und als Rohwert („Raw“) dargestellt. Für Diagnoseentscheidungen ist der Rohwert häufig aussagekräftiger, weil Normalisierungen herstellerspezifisch sind und sich Skalen sowie Zählweisen unterscheiden. Kritisch ist ein Attribut typischerweise dann, wenn (a) der normalisierte Wert den Threshold erreicht oder unterschreitet oder (b) Rohwerte auf fortschreitende Defekte hindeuten, obwohl der normalisierte Wert noch „gut“ wirkt.
Leseschlüssel: Rohwert, normalisierter Wert, Threshold und Grenzbereiche
Die folgende Referenz nutzt „typische Rohwerte“ als Praxisorientierung. „Grenzbereich“ meint keinen universellen Industriestandard, sondern eine konservative Heuristik: Werte, die in der Feldpraxis häufig mit erhöhtem Ausfallrisiko korrelieren oder die als Frühwarnindikatoren gelten. Bei SSDs sind viele klassische HDD-Attribute bedeutungslos oder anders belegt; umgekehrt liefern SSD-spezifische Indikatoren (Abnutzung, Reserveblöcke, Medienfehler) oft klarere Aussagen als „Error Rate“-Zähler.
- Normalisierter Wert/Threshold: Ein „SMART FAIL“ liegt vor, wenn der normalisierte Wert ≤ Threshold fällt; Tools markieren das oft als
FAILING_NOWoder „Pre-Fail“. Trotzdem können drohende Ausfälle bereits vorher sichtbar werden, wenn Rohwerte steigen. - Rohwert (Raw): Kann als dezimale Zahl, Hex, Bitfeld oder als mehrere Zähler (z. B. „High/Low“) kodiert sein. Besonders bei
01,07,C8undF1/F2unterscheiden sich Bedeutungen stark. - Trend statt Moment: Ein einmaliger Zählerstand ist weniger aussagekräftig als die Veränderung pro Zeit. Ein ansteigender Rohwert bei
05,C5oderC6gilt als deutliches Warnsignal. - Kontext: Hohe
C7-Fehler sprechen eher für Kabel/Port/Backplane als für Plattenoberfläche; Temperaturspitzen (C2) sind im Gehäusekontext zu bewerten; bei SSDs istE8/E9oft wichtiger als „Read Error Rate“.
Tabellarische Referenz: häufige SMART-Attribute (HDD/SSD) und Interpretation
| ID | Bezeichnung (üblich) | Technische Bedeutung | Typische Rohwerte | Grenzbereich (Praxis) | Praktische Interpretation |
|---|---|---|---|---|---|
| 05 | Reallocated Sectors Count | Anzahl ersetzter Sektoren (HDD) durch Reservesektoren. | 0 | >0, insbesondere steigend | Oberflächendefekte oder schwache Bereiche; bei Wachstum zeitnaher Austausch und vollständiges Backup. |
| C5 | Current Pending Sector Count | Sektoren, die aktuell nicht stabil lesbar sind und auf Remap warten (HDD). | 0 | >0 | Akutes Risiko für Lesefehler; oft Vorläufer von 05. Wenn nach „Stabilisierung“ nicht auf 0 zurückgeht, kritisch. |
| C6 | Uncorrectable Sector Count | Nicht korrigierbare Lesefehler (HDD; teils auch SSD als Medienfehler). | 0 | >0 | Starker Indikator für Datenverlustereignisse; bei HDD häufig mit defekten Sektoren korreliert. |
| C7 | UltraDMA CRC Error Count | Übertragungsfehler auf dem Interface (SATA/SAS-Transportpfad), nicht Medienfehler. | 0 | steigend, wiederkehrend | Typisch: Kabel/Stecker/Port/Backplane/EMI; Platte kann gesund sein. Steigende Werte trotz Kabeltausch als Hinweis auf Host-/Backplane-Probleme. |
| C2 | Temperature | Temperaturmesswert; Rohwert oft °C, teils min/max kodiert. | 30–45 °C (betrieblich häufig) | dauerhaft >55–60 °C (HDD), >70 °C (SSD Controller) je nach Modell | Erhöhtes Fehlerrisiko und Alterung; relevant sind Dauerlast und Hotspots, nicht einzelne kurze Peaks. |
| 09 | Power-On Hours | Betriebsstunden; Rohwert meist Stunden, teils in 30-Minuten- oder 1-Minuten-Schritten. | modell-/einsatzabhängig | kein fixer Grenzwert | Kontextwert für Alterung und Trendanalyse; zusammen mit Fehlerzählern interpretieren. |
| 0C | Power Cycle Count | Ein-/Ausschaltzyklen. | einsatzabhängig | kein fixer Grenzwert | Viele Zyklen können mechanische Belastung erhöhen (HDD); wichtig als Umfeldindikator (z. B. instabile Stromversorgung). |
| 04 | Start/Stop Count | Anzahl Spindel-Start/Stop (HDD). | einsatzabhängig | kein fixer Grenzwert; hohe Raten pro Tag auffällig | Kann bei aggressivem Energiemanagement steigen; Bewertung zusammen mit Load/Unload. |
| C1 | Load/Unload Cycle Count | Park-/Entladezyklen der Köpfe (HDD, v. a. Mobile/Green-Profile). | einsatzabhängig | sehr schnelle Zunahme auffällig | Hohe Zuwächse deuten auf häufiges Parken hin; nicht automatisch Defekt, aber Verschleißtreiber. |
| 0A | Spin Retry Count | Misslungene Anlaufversuche der Spindel (HDD). | 0 | >0 | Kann auf Motor-/Lager-/Stromversorgungsprobleme hinweisen; bei Auftreten ernst nehmen. |
| BC | Command Timeout | Kommandos, die nicht rechtzeitig abgeschlossen wurden (HDD/SSD; Controller/Link/Drive). | 0 | wiederkehrend, steigend | Kann auf Firmware-Hänger, Link-Probleme oder beginnende Defekte hindeuten; korreliert oft mit System-Logs. |
| E8 | Available Reserved Space (SSD, häufig) | Verfügbarkeit von Reserveblöcken; normalisiert oft 100→0, Rohwert je nach Vendor. | hoch/stabil | fallend, nahe Threshold | Sinkt bei zunehmenden Defekten/Remaps im NAND; nahe Schwellwert gilt als Austauschindikator. |
| E9 | Media Wearout Indicator (SSD, häufig Intel/ähnlich) | Abnutzungsindikator; häufig 100 (neu) → 0 (verbraucht). | 100…90… | deutlich fallend, nahe 0 | Spiegelt verbrauchte Program/Erase-Zyklen wider; zusammen mit TBW/Schreibvolumen betrachten. |
| F1 | Total LBAs Written (vendor-spezifisch) | Gesamtschreibmenge; Umrechnung in Bytes hängt von LBA-Größe/Kodierung ab. | steigend | kein fixer Grenzwert | Für SSD-Lebensdauerbewertung relevant; ohne exakte Vendor-Definition nur als Trend nutzen. |
| F2 | Total LBAs Read (vendor-spezifisch) | Gesamtlesemenge; Interpretation analog zu F1. |
steigend | kein fixer Grenzwert | Hilft bei Workload-Charakterisierung; selten direktes Ausfallkriterium. |
Herstellerunterschiede und typische Stolperstellen bei IDs und Rohwerten
Mehrere IDs tragen je nach Hersteller abweichende Labels oder Rohwertkodierungen. Bei manchen HDDs sind 01 (Read Error Rate) und 07 (Seek Error Rate) als interne Qualitätszähler implementiert, deren Rohwerte groß wirken können, ohne dass ein Defekt vorliegt; aussagekräftig ist dann eher der normalisierte Wert und dessen Trend. Bei SSDs werden klassische HDD-Konzepte (Seek/Spin) teils mit Platzhalterwerten belegt oder entfallen vollständig; entscheidend sind Attribute zu Reserveblöcken, Medienfehlern und Wear-Leveling.
Tools lesen SMART über unterschiedliche Pfade (ATA-Passthrough, SAT bei USB-Bridge, NVMe SMART/Log Pages) aus. Bei USB-Gehäusen können Attribute unvollständig sein oder in generische Felder gemappt werden; auffällige Werte sollten nach Möglichkeit direkt am nativen Interface gegengeprüft werden. Bei NVMe existiert eine eigene SMART-Logik; ein „SMART-Attribut“ im ATA-Sinn ist dort nicht garantiert vorhanden, auch wenn manche Tools eine ähnliche Tabelle anzeigen.
Praktische Grenzindikatoren (kompakt) für HDD vs. SSD
- HDD – Medienzustand: Jede Zunahme bei
05,C5oderC6gilt als ernst zu nehmender Frühwarnindikator; eine Kombination ausC5>0 undC6>0 spricht für unmittelbare Datenintegritätsprobleme. - HDD – Mechanik/Anlauf:
0A>0 oder wiederkehrende Timeouts (BC) sind verdächtig, insbesondere wenn gleichzeitig ungewöhnliche Geräusche, lange Zugriffszeiten oder Resets im Systemlog auftreten. - SATA-Link statt Laufwerk: Steigende
C7-Werte ohne Wachstum bei05/C5/C6deuten primär auf Signal-/Kabelprobleme; Abhilfe zielt aufSATA-Kabel, Port, Backplane und Stromversorgung. - SSD – Abnutzung/Reserve: Fallende Reserveindikatoren (
E8oder vendor-äquivalente Felder) und zunehmende Medienfehler sind relevanter als klassische „Error Rates“; nahe Threshold ist Austauschplanung geboten.
Herstellerunterschiede, Auswertung mit Diagnosetools und belastbare Frühwarnindikatoren für Datenverlust
Warum SMART zwischen Herstellern und Laufwerkstypen schwer vergleichbar ist
SMART liefert keine strikt normierte, herstellerübergreifend einheitliche Semantik für alle Attribute. Zwar existieren verbreitete Attribut-IDs und Bezeichnungen, doch Bedeutung, Skalierung und Schwellenwerte hängen von Firmware, Modellreihe und teils sogar Produktionscharge ab. Besonders die normalisierten Werte (typisch 0–100 oder 0–253) sind häufig vendor-spezifische Gesundheitsindikatoren, während die Rohwerte (Raw) je nach Implementierung Ereigniszähler, Zeitangaben, Datenmengen oder Bitfelder enthalten können.
Bei HDDs sind klassische Ausfallpfade wie Oberflächendefekte, Schreib-/Lesefehler und Mechanikverschleiß stärker abbildbar (z. B. über Sektorneuzuordnung und Pending-Sektoren). Bei SSDs dominieren hingegen Flash-spezifische Größen wie Abnutzung, Reserveblöcke, Program/Erase-Zyklen und Fehlerkorrektur-Statistiken. Viele SSD-Hersteller pflegen zusätzlich private Attribute, deren Interpretation ohne Dokumentation oder Feldbeobachtung unsicher bleibt. Für NVMe-SSDs kommt hinzu, dass ein Großteil der Zustandsdaten über NVMe-Logpages (z. B. „SMART/Health Information“) bereitgestellt wird und nicht deckungsgleich mit ATA-SMART ist.
Robuste Auswertung: Fokus auf Rohwerte, Trend und Ereignislogik
Belastbare Diagnosen entstehen selten aus einem einzelnen Snapshot. Entscheidend sind (1) ein plausibler Rohwert, (2) die Änderungsrate über Zeit sowie (3) die Korrelation mehrerer Attribute. Normalisierte Werte eignen sich primär für grobe Signale innerhalb einer Modellfamilie; herstellerübergreifende Vergleiche sollten stattdessen Rohwerte und deren zeitliche Entwicklung heranziehen. Wo Rohwerte als Bitfeld kodiert sind, ist die tool-spezifische Dekodierung kritisch: Unterschiede in Darstellung (dezimal/hexadezimal, High/Low-Word-Aufteilung) können Fehlinterpretationen erzeugen.
Ein weiterer Stolperstein sind „harmlos“ anmutende Fehlerzählungen, die bei hoher Last, schlechter Verkabelung oder instabiler Stromversorgung anwachsen. Beispielhaft zählen CRC-Fehler am SATA-Link typischerweise Übertragungsprobleme, nicht zwingend Plattendefekte. Umgekehrt sind bestimmte Ereigniszähler (z. B. Neuzuordnungen) direkt mit Datenintegritätsrisiken verbunden, weil sie auf nicht mehr zuverlässig lesbare oder schreibbare Bereiche hindeuten.
- Trendbildung: SMART-Snapshots in festen Intervallen erfassen und Delta-Werte je Attribut bilden; bei Windows liefert
smartctl -a /dev/sdXbzw. unter Windows z. B.smartctl -a /dev/sdX(je nach Device-Mapping) reproduzierbare Textausgaben für Versionierung. - Rohwert-Validierung: Bei ungewöhnlichen Rohwertformaten eine zweite Darstellung gegenprüfen, etwa
smartctl -x /dev/sdX(mehr Detailausgabe, inkl. Logs) und eine Hersteller-App, sofern verfügbar. - Kontextdaten einbeziehen: Schnittstellenfehler mit Infrastruktur korrelieren (Kabel, Backplane, HBA, Strom); bei SATA ist ein Anstieg von
UDMA_CRC_Error_Counttypischerweise ein Transport- oder Kontaktproblem, nicht automatisch ein Medienfehler. - Workload berücksichtigen: Hohe Queue-Tiefen, Vibrationen, hohe Temperaturen oder häufige Power-Cycles verändern Zählerstände; die Interpretation sollte Betriebsprofil und Laufwerksklasse (Desktop/NAS/Enterprise) einbeziehen.
Diagnosetools: konsistente Erfassung und typische Fallstricke
Für ATA/SATA-Laufwerke gilt smartmontools (smartctl) als Referenzwerkzeug, weil es Rohwerte, normalisierte Werte, Schwellen und SMART-Logs (Error Log, Selftest Log) in konsistenter Form ausliest. Grafische Tools können die Einordnung erleichtern, sind jedoch bei der Dekodierung einzelner Rohwerte oder bei USB-SATA-Bridges gelegentlich unpräzise. USB-Gehäuse und RAID-Controller können SMART-Daten filtern oder umkodieren; dann ist der korrekte Device-Passthrough entscheidend, andernfalls entsteht ein trügerisch „gesunder“ Status ohne vollständige Attributsicht.
Bei NVMe-SSDs sollten NVMe-spezifische Kennzahlen bevorzugt werden, darunter Medienfehler, kritische Warnflags, verfügbare Reserve und Prozentsatz der Lebensdauerverbrauchs. Einige Werkzeuge zeigen NVMe-Daten zusätzlich in ATA-ähnlicher Form an; die Quelle (NVMe-Log vs. emuliertes ATA-SMART) sollte klar sein, um doppelte oder missdeutete Werte zu vermeiden.
- Linux (ATA/SATA):
sudo smartctl -a /dev/sdXsudo smartctl -t short /dev/sdXsudo smartctl -l selftest /dev/sdX - Linux (NVMe):
sudo smartctl -a /dev/nvme0sudo nvme smart-log /dev/nvme0 - Windows (Grundsignal):
Get-PhysicalDisk | Select FriendlyName, HealthStatus, OperationalStatus(liefert kein vollwertiges SMART, aber ein schnelles OS-seitiges Statussignal). - USB-/Controller-Passthrough: Bei unvollständigen Daten gezielt mit smartctl-Device-Typ arbeiten, z. B.
smartctl -a -d sat /dev/sdX(Bridge-abhängig); Fehlschläge deuten häufig auf mangelndes Passthrough der Hardware hin.
Belastbare Frühwarnindikatoren: welche Signale wirklich zählen
Frühwarnindikatoren sollten zwei Kriterien erfüllen: Sie müssen (a) empirisch mit Ausfall-/Datenverlustrisiko korrelieren und (b) möglichst wenig von externer Peripherie beeinflusst sein. Für HDDs sind Medien- und Remapping-Signale typischerweise stärker als reine Interface-Fehler. Für SSDs sind „Media and Data Integrity Errors“ sowie Indikatoren für erschöpfte Reservekapazität und kritische Warnflags zentral, weil sie direkt auf die Fähigkeit zur Fehlerkorrektur und Blockverwaltung wirken.
| Indikator (typisch) | Belastbare Interpretation | Abgrenzung / Fallstrick |
|---|---|---|
| HDD: Reallocated Sectors (z. B. ID 05) steigt | Physische Medienprobleme; Remapping verbraucht Reserve. Steigende Rate ist stärker zu gewichten als ein historischer, stabiler Wert. | Einzelner alter Zählerstand kann aus früherem Ereignis stammen; entscheidend ist das Wachstum und begleitende Lesefehler. |
| HDD: Current Pending Sector / Offline Uncorrectable (z. B. ID C5/C6) > 0 | Konkrete, aktuell nicht zuverlässig lesbare Sektoren; hohes Risiko für I/O-Fehler und Datenverlust bei Zugriff. | Ein Pending-Sektor kann nach erfolgreichem Überschreiben verschwinden; bleibt er bestehen oder wandert in Reallocated, ist das Warnsignal bestätigt. |
| HDD: SMART-Error-Log Einträge, Selftests mit LBA-Fehlern | Fehler sind zeitlich und lokal (LBA) nachvollziehbar; Selftest-Log liefert harte Evidenz für Lesefehler. | Ohne Passthrough (RAID/USB) können Logs leer erscheinen; dann ist die Aussagekraft stark reduziert. |
| SATA: UDMA CRC Error Count (z. B. ID C7) steigt | Übertragungsstörung auf der Verbindung; Datenintegrität kann durch Retries meist erhalten bleiben, die Fehlerursache liegt oft außerhalb des Laufwerks. | Nicht mit Medienfehlern verwechseln; zuerst Kabel, Port, Backplane, Stecker, EMI und Stromversorgung prüfen. |
| NVMe: Critical Warning Flags gesetzt | Firmware meldet kritischen Zustand (z. B. unzuverlässiges Medium, verfügbare Reserve unter Schwellwert, Temperaturproblem). | Die genaue Flag-Bedeutung ist standardisiert, dennoch modellabhängige Trigger; Flags sollten zusammen mit Media Errors und Logeinträgen bewertet werden. |
| SSD/NVMe: Media and Data Integrity Errors / Media Errors > 0 oder zunehmend | Fehler, die die interne Datenintegrität betreffen; deutlicheres Risiko als reine Wear-Leveling-Zähler. | Einzelne Ereignisse können durch Stromausfall oder Firmware-Bugs beeinflusst sein; Zunahme und wiederkehrende Muster sind entscheidend. |
| SSD: Available Spare (fällt), Percentage Used (steigt in Richtung 100) | Reserveblöcke werden verbraucht bzw. Lebensdauerindikator nähert sich Herstellergrenze; begrenzte Fähigkeit zur Rekonstruktion/Remaps. | Die Skala ist hersteller- und modellabhängig, aber die Richtung ist eindeutig; sprunghafte Änderungen sind auffällig. |
Für eine belastbare Eskalation sollten harte Medienindikatoren (Pending/Uncorrectable/Reallocated bei HDD, Media Errors/Critical Warnings/Spare-Status bei SSD/NVMe) höher priorisiert werden als Temperaturspitzen oder Linkfehler. Gleichzeitig erhöht eine Kombination aus mehreren schwachen Signalen die Aussagekraft: etwa wachsende Reallocations zusammen mit Selftest-Fehlschlägen oder NVMe-Media-Errors zusammen mit sinkender Spare-Kapazität. Wo SMART uneindeutig bleibt, liefern Selftests und Fehlerlogs die technisch präziseste Evidenz, weil sie Ereignisse und betroffene Adressbereiche dokumentieren.
Werbung

(**) UVP: Unverbindliche Preisempfehlung
Preise inkl. MwSt., zzgl. Versandkosten