Viele KI-Anwendungen setzen standardmäßig auf Cloud-Dienste: Prompts und Eingabedaten verlassen dabei den eigenen Rechner, Latenzen hängen von Netzwerk und Auslastung ab, und Kosten entstehen oft pro Nutzung. Gleichzeitig sind Sprachmodelle (LLMs) und Bildgeneratoren inzwischen so verfügbar, dass sie sich auf Desktop-Systemen lokal ausführen lassen – je nach Modellgröße und Anspruch auch ohne High-End-Hardware. In der Praxis entscheidet jedoch nicht nur die nominelle Rechenleistung, sondern vor allem das Zusammenspiel aus VRAM-Größe, Speicherbandbreite, Quantisierung, Kontextlänge, Batch-Größen und I/O-Verhalten. Wer lokal arbeiten möchte, steht typischerweise vor sehr konkreten Fragen: Welche Aufgaben laufen sinnvoll auf CPU, wann lohnt sich eine GPU, wie viel RAM und VRAM braucht ein bestimmtes Modellprofil, und wie richtet man eine Umgebung so ein, dass Modelle reproduzierbar, updatebar und wieder sauber entfernbar bleiben – inklusive Caches, Download-Speicherorten und Laufzeitparametern.
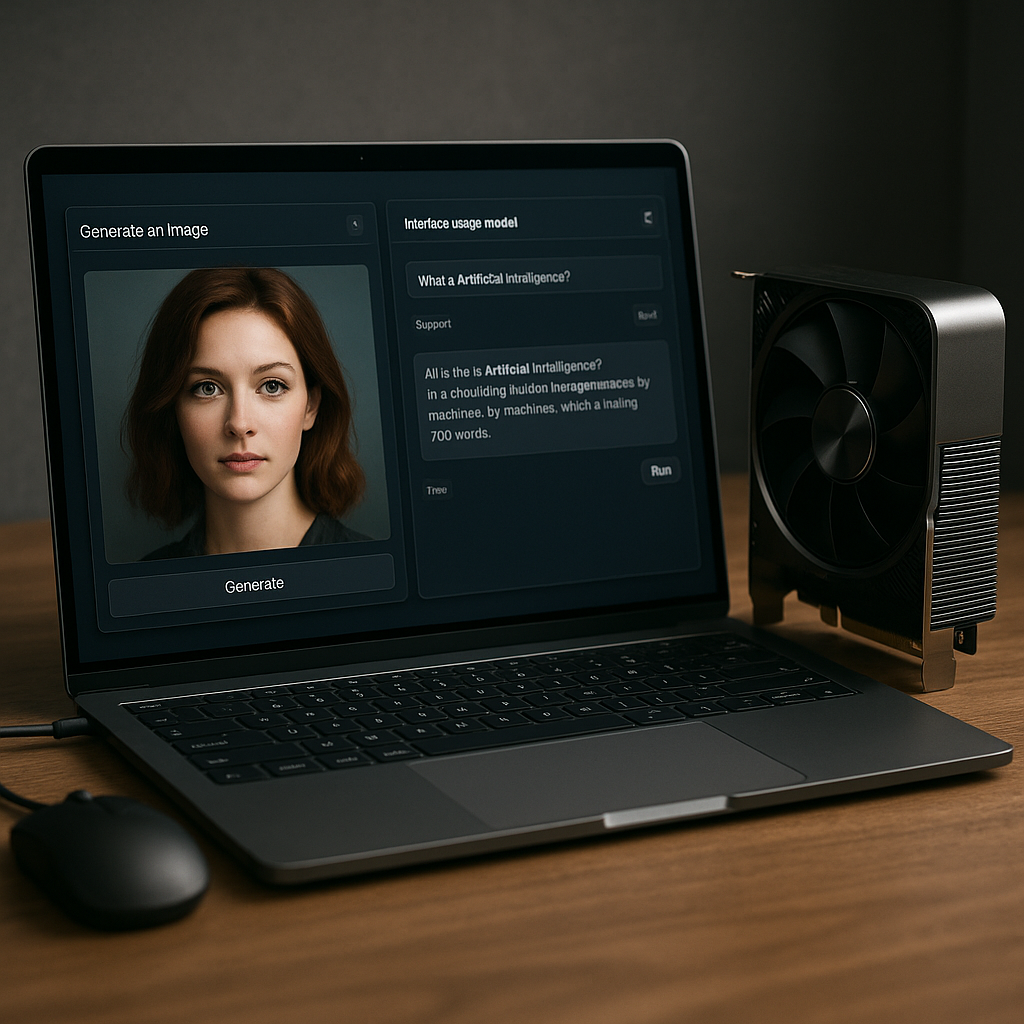
Hardware-Basis: CPU, GPU, RAM, VRAM, Speicherbandbreite und Massenspeicher im realen Modellbetrieb
Lokale Sprach- und Bildmodelle belasten Desktop-Hardware nicht „irgendwie“, sondern sehr spezifisch: Token für Token wird gerechnet, Gewichte werden wiederholt aus dem Speicher gelesen, Aktivierungen wandern durch Cache-Hierarchien, und beim Bild-Workflow kommen zusätzlich große Zwischen-Tensoren hinzu. Die gefühlte Geschwindigkeit entsteht daher aus dem Zusammenspiel von Rechendurchsatz, Speicherbandbreite und Datenhaltung (RAM/VRAM sowie Massenspeicher für Modellfiles und Caches). Wer die Engpässe korrekt einordnet, kann Hardware zielgerichtet auswählen und Laufzeiten konsistenter planen.
CPU: Kerne, Vektorbreite, Cache und Memory-Subsystem
CPU-Ausführung spielt eine zentrale Rolle, wenn kein diskreter Beschleuniger verfügbar ist, wenn Modelle sehr klein sind oder wenn die GPU durch VRAM-Limitierungen nicht sinnvoll genutzt werden kann. Für Inferenz ist weniger die maximale Turbo-Frequenz entscheidend als die dauerhaft haltbare Leistung unter Last, die Vektor-Instruktionsbreite (SIMD) und die Effizienz der Speicheranbindung. Moderne Inferenz-Backends nutzen auf x86 typischerweise AVX2, teils AVX-512, auf ARM NEON bzw. SVE/SVE2 (plattformabhängig). Entscheidend ist, ob der konkrete Build die jeweilige Instruktionsklasse tatsächlich verwendet; andernfalls fällt die Ausführung auf langsamere Pfade zurück.
Bei quantisierten LLMs (z. B. 8‑Bit bis 2‑Bit) verschiebt sich der Flaschenhals häufig in Richtung Speicherbandbreite und Cache-Trefferrate: Die Gewichte werden sehr oft gelesen, während pro gelesenem Byte vergleichsweise wenig Rechenarbeit anfällt. Große L3-Caches und ein gut dimensionierter Arbeitsspeicher-Controller können deshalb spürbarer sein als einzelne zusätzliche Kerne. Gleichzeitig profitieren Tokenizer, I/O und Orchestrierung von mehreren Threads, weshalb eine CPU mit ausreichend Kernen und guter Single-Thread-Leistung in der Praxis oft die robusteste Basis darstellt.
GPU: Recheneinheiten, VRAM-Größe, VRAM-Bandbreite und Treiberpfade
GPU-Inferenz gewinnt dann deutlich, wenn das Modell vollständig in den VRAM passt und der Pfad (z. B. CUDA, ROCm oder Metal) vom gewählten Runtime-Backend effizient genutzt wird. In diesem Szenario bestimmt neben dem reinen Compute vor allem die VRAM-Bandbreite das Tempo: LLM-Inferenz ist oft „bandwidth-bound“, weil bei jedem Token große Teile der Gewichte gelesen werden. Eine GPU mit hoher Speicherbandbreite kann daher bei identischer VRAM-Größe deutlich mehr Token pro Sekunde liefern als ein Modell mit niedriger Bandbreite.
Die VRAM-Größe wirkt als harte Kapazitätsgrenze. Passt das Modell nicht hinein, entstehen Mischformen: Ein Teil der Gewichte liegt im VRAM, der Rest wird aus dem Systemspeicher nachgeladen oder über PCIe gestreamt. Das reduziert den Durchsatz drastisch, weil PCIe-Transfers um Größenordnungen langsamer sind als VRAM-Zugriffe und zusätzlich CPU-Overhead verursachen. Praktisch relevant ist außerdem, dass Bildmodelle und Diffusions-Workflows neben den Gewichten zusätzliche Reserven für Aktivierungen, Attention-Caches, Scheduler-States und temporäre Buffers benötigen. Eine „knappe“ VRAM-Kalkulation funktioniert bei kurzen Textprompts oft noch, kippt aber bei höheren Auflösungen, größeren Batch-Größen oder langen Kontextfenstern.
RAM und Speicherdruck: Kontextfenster, KV-Cache und Nebenprozesse
Arbeitsspeicher ist im lokalen Betrieb nicht nur für das reine Laden von Modellgewichten relevant, sondern auch für Laufzeitdaten: Tokenizer, Zwischenrepräsentationen, Caches, Vektordatenbanken sowie der KV-Cache (Key/Value) bei Transformer-Modellen. Je länger das Kontextfenster und je mehr parallele Sessions, desto stärker wächst der Speicherbedarf. Auf Systemen, die mit GPU arbeiten, bleibt RAM wichtig, weil Loader, Pre-/Postprocessing und Teile der Pipeline (z. B. RAG-Index, Dokumentenparser, Bild-Decoding) außerhalb des VRAM laufen.
Unter Speicherdruck steigt die Auslagerung auf Massenspeicher (Pagefile/Swap). Das verschlechtert Latenz und Durchsatz sprunghaft und führt in interaktiven Workflows zu ungleichmäßigem Verhalten: Token kommen in „Bursts“, und die UI wirkt blockiert, obwohl die Recheneinheiten formal ausgelastet sind. Stabilere Ergebnisse entstehen, wenn genügend RAM als Puffer vorhanden ist, sodass Betriebssystem-Caching und Modell-Cache nicht gegeneinander arbeiten müssen.
- LLM-Inferenz (interaktiv): Typisch dominieren KV-Cache und laufende Session-Daten; lange Kontexte erhöhen den RAM/VRAM-Bedarf auch bei gleichbleibender Modellgröße.
- Batching und Parallelität: Mehr gleichzeitige Anfragen erhöhen Aktivierungen und Buffer; eine aggressive Parallelisierung kann auf knappen Systemen langsamer sein als serieller Betrieb.
- Speicherfragmentierung: Lange Laufzeiten mit häufigem Laden/Entladen großer Modelle können Fragmentierung verstärken; ein Neustart der Runtime ist dann oft der schnellste Weg zu wiederholbarer Allokation.
VRAM vs. RAM: Offloading, Unified Memory und PCIe als Engpass
Zwischen VRAM und RAM liegt ein physischer Transportweg. Bei diskreten GPUs läuft er primär über PCIe; selbst bei PCIe 4.0/5.0 bleibt die effektive Bandbreite und vor allem die Latenz weit hinter VRAM zurück. Offloading (teilweises Auslagern von Layern oder Gewichten in den Systemspeicher) kann ein „Starten statt Nichtstarten“ ermöglichen, ist aber fast immer ein Trade-off gegen Tokenrate und Reaktionszeit. Zudem steigt die Empfindlichkeit gegenüber Hintergrundlast: Schon moderate I/O- oder Speicherlast anderer Anwendungen kann den Transferpfad stören und die Inferenz unruhig machen.
Bei Unified-Memory-Architekturen (z. B. integrierte GPUs mit gemeinsamem Speicher oder Plattformen mit sehr enger CPU/GPU-Speicherintegration) verschiebt sich das Problem: Der harte VRAM-Deckel entfällt teilweise, doch CPU und GPU konkurrieren stärker um die gleiche Speicherbandbreite. Inferenz kann dann nicht „abstürzen“, aber bei hoher Auslastung von beiden Seiten deutlich variieren. Für reproduzierbare Latenzen ist es relevant, ob die GPU tatsächlich auf dedizierten schnellen Speicher zugreifen kann oder ob sie systemweit Bandbreite teilt.
Massenspeicher: Modellfiles, Cache-Hierarchie und Ladezeiten
Modelle bestehen aus großen Binärdateien (häufig mehrere Gigabyte). Massenspeicher bestimmt damit nicht nur die Installationsgröße, sondern auch Ladezeiten, Update-Zyklen und das Verhalten beim Modellwechsel. Eine NVMe-SSD reduziert Wartezeiten spürbar, vor allem wenn Modelle häufiger gewechselt oder mehrere Varianten getestet werden. Beim ersten Laden nach einem Update ist der „kalte“ Pfad relevant (Dekompression, Hash-Prüfung, ggf. Konvertierung). In späteren Läufen kann der Betriebssystem-Dateicache viele Reads abfangen, sofern genug RAM frei bleibt.
Zusätzlich entstehen Caches: Tokenizer-Artefakte, kompilierte Kernel (je nach Backend), Zwischendateien für Bildpipelines oder persistente Model-Registries. Diese Daten sind technisch unkritisch, aber im Alltag entscheidend für Speicherplanung und Fehlersuche. Läuft das Laufwerk voll, scheitern Downloads, Entpacken oder Checkpoint-Konvertierungen oft ohne aussagekräftige Meldung. Sinnvoll ist daher, Modell- und Cache-Pfade bewusst auf ein Laufwerk mit Reserve zu legen und Schreibzugriffe (z. B. temporäre Dateien) nicht auf sehr langsame Medien auszulagern.
| Komponente | Typischer Engpass im lokalen Modellbetrieb | Praktisches Symptom |
|---|---|---|
| CPU | Speicherbandbreite/Cache bei quantisierten LLMs; Single-Thread bei Tokenizer/Orchestrierung | Gleichmäßige, aber niedrige Tokenrate; UI wirkt träge bei hoher Hintergrundlast |
| GPU | VRAM-Bandbreite und VRAM-Kapazität; Treiber-/Backend-Pfad | Hohe Tokenrate solange Modell im VRAM bleibt; starker Einbruch bei Offloading |
| RAM | KV-Cache, Parallelität, OS-Cache vs. Swap | Plötzliche Latenzspitzen, „Ruckeln“, Auslagerung auf Pagefile/Swap |
| Massenspeicher | Sequentielle Reads großer Modellfiles; Platz für Caches/Updates | Lange Start- und Wechselzeiten; Fehler bei Download/Entpacken bei knapper Kapazität |
Daumenregeln zur Dimensionierung nach Workload
Für Textmodelle zählt zuerst die Frage, ob das Zielmodell (inklusive Laufzeit-Overhead) in den VRAM passt. Ist das gegeben, entscheidet die VRAM-Bandbreite über den Durchsatz; zusätzliche Recheneinheiten bringen nur dann etwas, wenn die Pipeline nicht bereits bandbreitenlimitiert ist. Bei CPU-only-Setups wird Speicherbandbreite zusammen mit effizienter Vektor-Ausführung maßgeblich, weshalb Plattformen mit guter RAM-Anbindung und großem Cache häufig stabilere Tokenraten liefern als rein taktoptimierte Konfigurationen.
Bei Bildgenerierung verschiebt sich die Priorität: Auflösung, Anzahl der Schritte und vor allem zusätzliche Komponenten (z. B. Upscaler, Control-Module, mehrere Text-Encoder) erhöhen den VRAM-Bedarf sprunghaft. Wer solche Workflows reproduzierbar fahren muss, profitiert meist stärker von mehr VRAM als von einer moderaten Steigerung der Recheneinheiten. Unabhängig vom Modelltyp gilt: Ein ausreichend dimensionierter RAM-Puffer und ein schneller Massenspeicher reduzieren nicht die reine Rechenzeit pro Token oder Schritt, verhindern aber die typischen „Klippen“ durch Nachladen, Swap oder Cache-Evictions und machen das System deutlich berechenbarer.
Lokale Laufzeitumgebung aufsetzen: Model-Runner, Modellverwaltung, Konfiguration, Caching, Updates und Deinstallation
Model-Runner auswählen und Grundbetrieb etablieren
Eine lokale Laufzeitumgebung besteht praktisch aus einem „Runner“ (Inferenz-Backend plus Server/CLI), einem Ablagekonzept für Modelle sowie klaren Regeln, wie Konfiguration, Caches und Updates gehandhabt werden. In der Desktop-Praxis haben sich zwei Werkzeugklassen etabliert: (1) Runner, die Modelle als Artefakte verwalten und per lokaler API bereitstellen, und (2) direkte Backends, die Modelle aus einer Datei (häufig .gguf) laden und über CLI-Parameter gesteuert werden. Bei Sprachmodellen dominiert der llama.cpp-Ökosystempfad (auch in GUIs eingebettet), während Bildmodelle meist über Stable-Diffusion-Frontends mit austauschbaren Backends (z. B. PyTorch mit CUDA/ROCm/Metal) laufen.
Für einen robusten Betrieb ist eine saubere Trennung zwischen „Runner-Prozess“ und „Client“ hilfreich: Der Runner hält Modelle im Speicher, übernimmt Tokenisierung, Streaming und ggf. Tool-Aufrufe; Clients sind Terminal, Editor-Plugin oder Web-UI. Damit bleiben Ressourcenlimits, Logging und Netzwerkgrenzen eindeutig. Auf Desktop-Systemen wird typischerweise nur an 127.0.0.1 gebunden; bei Bind an 0.0.0.0 entsteht sofort Angriffsfläche im lokalen Netz, insbesondere wenn keine Authentifizierung aktiv ist.
Für den Start empfiehlt sich ein minimaler Pfad: ein Runner für LLMs (z. B. ollama oder ein llama.cpp-basierter Server) und ein Frontend für Stable Diffusion (z. B. ComfyUI oder AUTOMATIC1111). Entscheidend ist weniger die Oberfläche als die Fähigkeit, Modelle versioniert zu verwalten, Konfiguration reproduzierbar zu halten und Speicherpfade kontrolliert festzulegen.
Modellverwaltung: Formate, Ablageorte, Reproduzierbarkeit
Bei LLMs sind zwei Strategien verbreitet: verwaltete „Model-Repos“ (Runner lädt nach Manifest und prüft Integrität) oder manuelles Ablegen von Modelldateien, typischerweise GGUF für llama.cpp-kompatible Runner. Reproduzierbarkeit hängt an drei Punkten: exakte Modell-ID/Checksumme, Quantisierungsstufe und Inferenzparameter (Kontextlänge, Sampling, Offload-Verteilung). Bei Bildmodellen kommen zusätzliche Artefakte hinzu: Basis-Checkpoint (.safetensors), VAE, Text-Encoder, LoRAs, ControlNet-Modelle und ggf. Upscaler. Ohne ein konsistentes Verzeichnis- und Namensschema steigen Fehlerquoten durch doppelte Dateien, unklare Versionen oder kollidierende Abhängigkeiten.
| Komponente | Typische Ablage (Beispiele) und Hinweise |
|---|---|
| LLM-Modelle (GGUF) | ~/models/llm/ oder ein Runner-spezifischer Store; optional getrennt nach Q4_K_M, Q5_K_M, Q8_0; Checksummen dokumentieren. |
| Stable-Diffusion-Checkpoints | Frontend-Pfad wie models/Stable-diffusion/; Basismodelle, Inpainting, Refiner getrennt halten; nur .safetensors bevorzugen. |
| LoRA / ControlNet / VAE | models/Lora/, models/ControlNet/, models/VAE/; Versionen im Dateinamen oder per Begleitdatei fixieren. |
| Outputs und Zwischenergebnisse | Getrennte Ordner für outputs/, temp/, cache/; erleichtert Bereinigung und Backup-Strategien. |
Eine praktische Mindestdisziplin ist eine einfache Inventardatei pro Modellordner, die Herkunft, Hash (z. B. SHA256), Lizenzhinweise und die getestete Runner-Version notiert. Das verhindert, dass nach einem Update plötzlich andere Ergebnisse entstehen, obwohl „das gleiche Modell“ vermeintlich noch vorhanden ist.
Konfiguration und Ressourcensteuerung: Ports, Threads, GPU-Offload, Limits
Laufzeitkonfiguration sollte explizit und minimal gehalten werden: Bind-Adresse/Port, Modellpfad, Kontextlänge, Batch-Größen sowie GPU-Offload/Device-Auswahl. Bei llama.cpp-basierten Runnern sind die großen Hebel (a) Anzahl CPU-Threads, (b) GPU-Layer-Offload bzw. Backend (CUDA/Metal/Vulkan), (c) KV-Cache-Strategie und (d) Parallelität (gleichzeitige Requests). Bei Stable Diffusion sind Batch- und Auflösungsspitzen der häufigste Grund für VRAM-Überläufe; hinzu kommen optionale Features wie Xformers/SDPA, die je nach Treiber- und PyTorch-Version andere Speicherprofile zeigen können.
Für den Desktop-Betrieb lohnt sich eine harte Begrenzung der gleichzeitigen Jobs. Viele UIs starten Worker-Pools oder erlauben parallele Queues; das erhöht Durchsatz, verschärft aber Fragmentierung im VRAM und treibt den RAM-Footprint durch Duplikate von Gewichten und Aktivierungen. Sinnvoll ist außerdem, Log-Ausgaben persistent abzulegen (Rotationsprinzip), um Fehlerbilder wie CUDA out of memory, Kernel-Fallbacks oder unerwartete Quantisierungswarnungen nachvollziehen zu können.
- Lokaler API-Server (Beispiel): Bind an Loopback und definierter Port, z. B.
--host 127.0.0.1 --port 11434 - CPU-Thread-Limit (Beispiel): Threads begrenzen statt „alle Kerne“, z. B.
--threads 8oder per UmgebungOMP_NUM_THREADS=8 - GPU-Auswahl (Beispiel): Device explizit setzen, z. B.
CUDA_VISIBLE_DEVICES=0oder bei ROCmHIP_VISIBLE_DEVICES=0 - Kontext und KV-Cache (Beispiel): Kontext nicht unnötig hochziehen; Parameter wie
--ctx-size 8192erhöhen Speicherbedarf deutlich und können Swap- oder VRAM-Druck auslösen.
Konfigurationsdateien sollten außerhalb von Installationsverzeichnissen liegen, damit Updates keine lokalen Anpassungen überschreiben. Bei mehreren Runnern ist ein zentraler „Settings“-Ort pro Host hilfreich, ergänzt um pro Projekt/Workflow getrennte Presets (z. B. „Code“, „Long Context“, „Inpainting“). Für wiederholbare Runs bei Bildmodellen gehören Seed, Sampler, Steps und exakte Modellkombinationen in diese Presets.
Caching und Speicherorte: Download-Cache, Build-Artefakte, Tokenizer
Lokale KI-Stacks erzeugen mehrere Cache-Schichten: (1) Modell-Download-Cache (Registry/Hub oder Runner-Store), (2) Framework-Caches (PyTorch, Triton, JIT-Kompilate), (3) Tokenizer/Preprocessing-Artefakte und (4) UI-spezifische Thumbnails/Metadaten. Diese Schichten sind funktional, können aber schnell hunderte Gigabyte belegen und auf Systemlaufwerken zu Engpässen führen. Deshalb sollten Cache-Pfade früh festgelegt und, wenn möglich, auf ein Datenlaufwerk verschoben werden.
Typische Orte: Unter Linux liegen viele Caches unter ~/.cache/ (z. B. ~/.cache/huggingface/, ~/.cache/torch/), unter Windows häufig in %LOCALAPPDATA% und %APPDATA%, unter macOS in ~/Library/Caches/. Runner mit eigener Modellverwaltung nutzen oft einen dedizierten Store (häufig unter dem Home-Verzeichnis). Technisch relevant: Einige Caches sind „write-once, read-many“ (Modelldateien), andere werden bei Treiber- oder Framework-Updates ungültig (Kernel- und JIT-Caches). Bei unerklärlichen Performance-Einbrüchen nach Updates kann ein gezieltes Leeren von Build-Caches sinnvoll sein, während ein Löschlauf im Modellstore nur unnötige Re-Downloads auslöst.
Für Offline-Betrieb ist ein vollständiger Cache-Stand Voraussetzung. Bei Hugging-Face-basierten Workflows sollte klar sein, dass neben Gewichten auch Tokenizer-Dateien und Konfigurationsdateien benötigt werden; sonst startet die Pipeline nicht, obwohl das Gewicht bereits lokal liegt. Einige UIs laden Zusatzmodelle (z. B. Upscaler) „on demand“ nach; diese Autodownloads sollten deaktiviert oder vorab in den Modellpfad gespiegelt werden, wenn der Desktop dauerhaft ohne Netz laufen soll.
Update-Strategien: Treiber, Runner, Modelle – ohne Drift
Updates wirken in drei Ebenen: GPU-Treiber/Runtime (CUDA/ROCm/Metal), Inferenzsoftware (Runner/UI/Python-Environment) und Modelle. Jede Ebene kann Ergebnisse verändern: Ein Treiberupdate ändert Kernel-Auswahl und Speicherverwaltung, ein PyTorch-Update kann andere Attention-Implementierungen aktivieren, und Modellupdates überschreiben Gewichte oder Metadaten. Stabilität entsteht durch Versionierung und Entkopplung: Runner und UIs sollten möglichst in isolierten Umgebungen laufen (venv/conda oder Container), und Modellstände sollten nie „in place“ ersetzt werden, sondern parallel als neue Version abgelegt.
Für verwaltete Runner-Stores empfiehlt sich ein Pull-Mechanismus mit fixierten Tags/Hashes statt „latest“. Bei Bildmodellen ist die Versionsbindung von LoRAs und ControlNet-Modellen besonders relevant, weil kleine Variationen im Preprocessing oder in der Architekturkompatibilität (SD 1.5 vs. SDXL vs. Flux-Varianten) sonst zu schwer interpretierbaren Artefakten führen. Wo möglich, sollten Updates zuerst in einem separaten Profil getestet werden, das auf derselben Hardware läuft, aber eigene Caches und Konfigurationsdateien nutzt.
Deinstallation und Bereinigung: sauber entfernen, Daten gezielt behalten
Die Deinstallation lokaler KI-Komponenten scheitert in der Praxis weniger am Programm selbst als an zurückbleibenden Stores und Caches. Ein „Uninstall“ entfernt häufig nur Binaries und GUI, nicht aber Modelldateien, Python-Wheels, JIT-Artefakte und Output-Verzeichnisse. Deshalb sollte vorab entschieden werden, welche Daten erhalten bleiben: Modelle (teuer im Download), Outputs (projektbezogen), Konfiguration/Presets (wertvoll für Reproduzierbarkeit) und Logs (für Fehleranalyse) sind getrennt zu behandeln.
- Runner-Store identifizieren: Speicherort dokumentieren und bei Bedarf manuell löschen, z. B. unter
~/.ollama/oder einem benutzerdefinierten Modellpfad; zuvor prüfen, ob Symlinks/Junctions verwendet werden. - Framework-Caches bereinigen: typische Orte sind
~/.cache/torch/,~/.cache/huggingface/oder unter Windows%LOCALAPPDATA%; nur löschen, wenn Rebuild/Redownload akzeptabel ist. - Python-Umgebungen entfernen: venv/conda-Verzeichnisse separat behandeln; Pfade wie
./venv/oder Conda-Env-Ordner löschen, statt System-Python zu verändern. - Dienste und Autostart prüfen: Hintergrunddienste deaktivieren, z. B. systemd-Units unter
~/.config/systemd/user/oder Autostart-Einträge; nur lokale Bindings beibehalten.
Bei Windows-Installationen ist zusätzlich relevant, ob CUDA-Runtimes, Visual-C++-Redistributables oder ROCm-Komponenten systemweit installiert wurden; diese sollten nur entfernt werden, wenn keine anderen Workloads davon abhängen. Generell verhindert eine früh festgelegte Ordnerstruktur (Modelle/Outputs/Cache getrennt) spätere „Alles-oder-nichts“-Löschaktionen und erleichtert eine saubere Migration auf neue Laufwerke oder einen zweiten Desktop.
Typische Workflows ohne Cloud: Text- und Codeunterstützung, Bildgenerierung und Modellwahl nach Aufgabenprofil
Lokale KI-Workflows folgen in der Praxis wiederkehrenden Mustern: Modelle werden einmalig geladen, ein Kontext (Systemprompt, Datei- oder Projektwissen) wird vorbereitet, anschließend laufen kurze Iterationen aus Prompt, Ergebnis und Anpassung. Entscheidend ist, den Ressourcenverbrauch über Session-Grenzen hinweg kontrollierbar zu halten, damit Textassistenz, Codeanalyse oder Bildgenerierung auf Desktop-Systemen stabil bleibt. Dazu gehören eine saubere Modellwahl, bewusst gesetzte Laufzeitparameter und klare Abläufe für Import, Caching und Ausgabeformate.
Textassistenz lokal: Zusammenfassen, Umschreiben, Extrahieren
Für Textaufgaben dominiert die Latenz pro Token und die Kontextlänge. Bei lokal betriebenen LLMs entscheidet die verfügbare VRAM-Größe (oder bei CPU-Betrieb RAM plus Speicherbandbreite) darüber, ob ein Modell vollständig im schnellen Speicher liegt oder während der Generierung ständig nachgeladen werden muss. In der Praxis bewährt sich ein Setup, das zwischen einem „Alltagsmodell“ für kurze Antworten und einem größeren Modell für tiefe Analysen unterscheidet.
Typische Textworkflows bestehen aus Vorverarbeitung (z. B. PDF-Text extrahieren, Normalisierung), einem Prompt-Template mit klaren Ausgabevorgaben (Stil, Länge, Format), optionaler Quellenbeilage und einer Nachverarbeitung, die Ergebnisqualität prüft. Ohne Cloud empfiehlt sich, Ausgaben deterministisch zu halten: niedrige Temperatur und feste Sampling-Parameter erleichtern Reproduzierbarkeit, etwa bei Protokollzusammenfassungen oder Extraktion von Entitäten in JSON.
- Prompt- und Sampling-Disziplin: Für stabile Extraktion
temperature=0bzw. sehr niedrig, Begrenzung übermax_tokensund Wiederholungsbremse überrepeat_penalty; bei vielen Laufzeiten existieren äquivalente Optionen mit ähnlicher Bedeutung. - Kontextfenster als Kostenfaktor: Große Kontexte erhöhen Speicherbedarf und Vorlaufzeit; in GUIs und Servern wird das häufig über
context_lengthodern_ctxkonfiguriert und sollte an die Aufgabe gekoppelt werden (kurze E-Mails vs. lange Verträge). - Datei- und Notiz-Workflows: Lokale Ablagen lassen sich über Pfade wie
~/Dokumente/(Linux/macOS) oder%USERPROFILE%\Documents(Windows) in Tools einbinden; sinnvoll ist eine Trennung zwischen Rohdaten, extrahiertem Text und finalen Ausgaben.
Codeunterstützung: Erklären, Refactoring, Tests und Diff-basierte Änderungen
Bei Codeaufgaben zählt weniger „Kreativität“ als präzise Kontextführung. Lokal laufende Code-LLMs profitieren von strukturierten Eingaben: relevante Dateien, ein kurzer Projektüberblick, Build- und Lint-Ausgaben sowie klare Constraints (Programmiersprache, Stilregeln, Zielruntime). Im Desktop-Betrieb entstehen zwei stabile Varianten: Chat-orientierte Assistenz für Erklärungen und eine Patch-orientierte Assistenz, die Änderungen als Diff liefert. Letztere erleichtert Kontrolle, weil die KI nicht ganze Dateien neu erfindet, sondern minimal-invasive Änderungen vorschlägt.
Für größere Repositories setzt sich ein Retrieval-Ansatz durch: Quelltext wird lokal indiziert, in Embeddings überführt und bei einer Anfrage werden nur passende Ausschnitte dem Prompt beigelegt. Das reduziert Kontextverbrauch, ohne die lokale Offline-Eigenschaft zu verlieren. Entscheidend ist, dass Index und Cache auf dem lokalen Datenträger verbleiben und dass die Toolchain klare Grenzen für Dateizugriffe einhält (Allowlist statt „ganzer Home-Ordner“). Für Tests und Build-Fehler eignet sich ein Loop aus Diagnoseprompt, Ausgabe der Fehlermeldung und gezielten Fix-Vorschlägen, anschließend erneutes lokales Ausführen der Toolchain.
| Aufgabe | Lokales Muster | Technische Stellschrauben |
|---|---|---|
| Refactoring kleiner Module | Diff/patch, Fokus auf betroffene Dateien | Kontextlimit, deterministisches Sampling, Ausgabeformat „Unified Diff“ |
| Fehleranalyse | Fehlerlog + minimaler Codeauszug + Hypothese | Kurzer Kontext, niedrige Temperatur, strikte Anforderungen an reproduzierbare Schritte |
| Repository-Fragen | Lokales Retrieval (Embeddings) + Chat-LLM | Indexpfad, Chunk-Größe, Top‑k Treffer, Trennung von Index und Projekt-Workspace |
Bildgenerierung lokal: Prompting, Auflösung, VRAM-Budget und Iterationen
Lokale Bildmodelle verhalten sich anders als Textmodelle: Speicherbedarf und Rechenlast steigen stark mit Auflösung, Batch-Größe und zusätzlichen Modulen (z. B. ControlNet, Upcaler, IP-Adapter). Während Textinferenz oft an Tokenrate und Kontext hängt, ist Bildinferenz meist VRAM-limitiert. Reicht VRAM nicht aus, weichen viele Laufzeiten auf CPU/RAM aus oder aktivieren speichersparende Pfade; das erhöht die Laufzeit deutlich und kann bei knappen Systemen zu Fragmentierung oder OOM-Fehlern führen.
Ein robuster Workflow startet mit niedriger Auflösung und wenigen Schritten, um Komposition und Stil zu stabilisieren. Erst danach folgen Upscaling, Inpainting und Variantenbildung. Für Reproduzierbarkeit bleibt der Seed fix, solange nur einzelne Parameter geändert werden. Negative Prompts, feste Sampler-Einstellungen und eine dokumentierte Prompt-Historie helfen, Ergebnisse später nachzustellen, ohne auf Cloud-Logbücher angewiesen zu sein.
- Iteratives Vorgehen: Erstentwurf mit moderater Größe, danach gezielte Verfeinerung; Stabilität steigt bei konstantem
seedund klaren Änderungen pro Iteration (z. B. nurCFGoder nur Schritte). - VRAM-Steuerung: Speicherverbrauch hängt von Auflösung, Batch und Zusatzmodulen ab; typische Hebel sind
batch_sizereduzieren, Kachel-/Tiled-Upscaling aktivieren und speichersparende Attention-Varianten nutzen, sofern die jeweilige Runtime sie anbietet. - Komponenten getrennt halten: Checkpoints, LoRAs, VAE und Control-Modelle sollten in separaten Verzeichnissen liegen; viele GUIs erlauben dafür explizite Modellpfade in einer Konfigurationsdatei, was Duplikate im Cache reduziert.
Modellwahl nach Aufgabenprofil: Größe, Quantisierung, Kontext und Spezialisierung
Die Modellwahl entscheidet über den größten Teil des Nutzererlebnisses, weil sie Latenz, Speicherbedarf und Ergebnischarakter prägt. Für Text und Code existieren Allround-LLMs, die breit einsetzbar sind, sowie spezialisierte Varianten für Programmcode oder bestimmte Sprachen. Lokal kommen zusätzlich Quantisierungen ins Spiel: Niedrigere Bitbreiten senken RAM/VRAM-Bedarf und beschleunigen oft das Laden, können aber Präzision und Robustheit bei komplexen Aufgaben reduzieren. Die passende Wahl hängt daher am Aufgabenprofil, nicht am maximalen Parametercount.
Für Codeunterstützung sind Modelle mit starker Trainingsbasis auf Repositories und Instruktionsdaten sinnvoll; für Textproduktion zählt häufig Stiltreue und Kontextlänge. Für Retrieval-Workflows wird zusätzlich ein Embedding-Modell benötigt, dessen Dimension und Tokenizer zum Index und zur Sprache passen. Bei Bildmodellen ist die Baseline (SDXL-ähnliche Architektur vs. kleinere Varianten) und die Verfügbarkeit passender Zusatzgewichte entscheidend; die beste Praxis ist, ein Basismodell stabil zu halten und Experimente über LoRAs oder Control-Modelle abzubilden, statt ständig komplette Checkpoints zu wechseln.
| Aufgabenprofil | Bevorzugte Eigenschaften | Praktische Implikation lokal |
|---|---|---|
| Kurze Texte, E-Mails, Umformulierung | Gute Instruktionsbefolgung, niedrige Latenz | Kleineres LLM, moderate Quantisierung, kleineres Kontextfenster |
| Lange Dokumente, Analyse, strukturierte Extraktion | Großes Kontextfenster, Stabilität bei niedriger Temperatur | Mehr VRAM/RAM, vorsichtiges Sampling, ggf. Retrieval statt riesigem Kontext |
| Code: Refactoring, Tests, Fehlersuche | Codeverständnis, Diff-orientierte Ausgabe | Code-spezifisches LLM, strikte Ausgabeformate, kurze reproduzierbare Schritte |
| Bild: Illustrationen, Produktshots, Variationen | Kompositionsstärke, Steuerbarkeit über Zusatzmodule | VRAM-Planung nach Auflösung/Modulen, iterativ mit Seed, Upscaling getrennt |
In allen Workflows zahlt sich eine klare Trennung zwischen Modellen, Projektdaten und generierten Artefakten aus. Lokale Tools legen häufig eigene Caches an (Modelldownloads, Tokenizer-Dateien, kompilierten Kernels, Thumbnail- oder Prompt-Historien). Für reproduzierbare Ergebnisse und nachvollziehbare Ressourcennutzung bleiben diese Speicherorte dokumentiert, und Updates erfolgen kontrolliert: Modellversionen werden pinnenbar gehalten, während Laufzeiten und GUIs getrennt aktualisiert werden, um inkompatible Formatwechsel oder unerwartete Neukompilierung im Arbeitsbetrieb zu vermeiden.
Werbung

(**) UVP: Unverbindliche Preisempfehlung
Preise inkl. MwSt., zzgl. Versandkosten